This article is available in English — Read in English
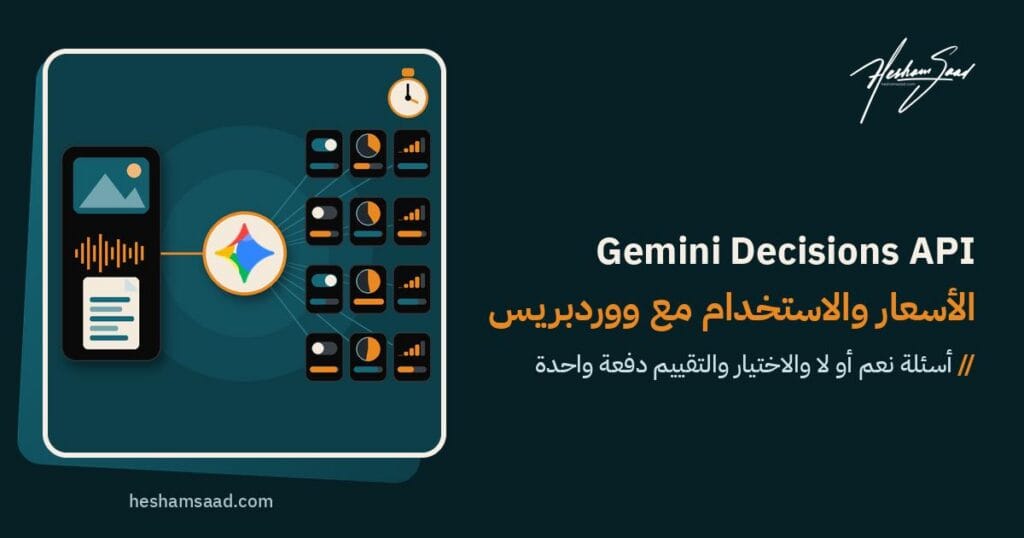
أعلنت شركة جوجل في 11 نوفمبر 2026 عن إطلاق واجهة Gemini Decisions API الجديدة كليا، وهي نقطة اتصال برمجية مخصصة لاتخاذ القرارات السريعة ضمن خيارات محددة ومغلقة، وتعمل بواسطة نموذج جديد يحمل اسم Gemini Decision 1 داخل منصة Google AI Studio. وتأتي هذه الخطوة لتعالج مشكلة شائعة يواجهها المطورون وأصحاب الأعمال عند استخدام النماذج اللغوية الكبيرة في مهام لا تحتاج أصلا إلى كتابة فقرات أو صياغة جمل، بل تحتاج فقط إلى قرار واضح مثل نعم أو لا، أو اختيار تصنيف من قائمة، أو إعطاء تقييم رقمي.
عندما تدير متجرا إلكترونيا على ووكومرس أو موقع خدمات يعتمد على ووردبريس في مصر أو السعودية أو دول الخليج، فإن جزءا كبيرا من العمليات اليومية يدور حول الفرز والتصنيف. أنت تريد معرفة هل هذا التعليق رسالة مزعجة أم سؤال حقيقي من عميل، وهل صورة المنتج التي رفعها البائع واضحة ومطابقة للسياسات أم لا، وأي قسم في الشركة يجب أن يستلم تذكرة الدعم الفني الحالية.
في السابق كان تنفيذ هذه المهام بالذكاء الاصطناعي يتطلب إرسال المحتوى إلى نموذج توليدي وانتظاره حتى يكتب إجابة نصية أو كائنا بصيغة JSON رمز تلو الآخر، مع دفع تكلفة رموز المخرجات والتفكير. في هذا الدليل نشرح تفاصيل الواجهة الجديدة من واقع وثائق جوجل الرسمية، ونقارنها بالبدائل المنافسة، ونوضح كيف يمكن توظيفها برمجيا داخل مواقع ووردبريس ومتاجر ووكومرس بأمان وكفاءة.
ما هي Gemini Decisions API وكيف تختلف عن النماذج التوليدية؟
تعتمد النماذج التوليدية المعتادة على إنتاج النصوص كلمة بكلمة أو رمزا بعد رمز، وهو أمر ممتاز عندما تطلب من النموذج كتابة وصف منتج أو تلخيص تقرير أو صياغة رد كامل لعميل. لكن عندما يكون المطلوب مجرد اتخاذ قرار برمجي محدد من بين بدائل معروفة مسبقا، فإن توليد النصوص يصبح عبئا إضافيا يستهلك وقتا أطول ويرفع الفاتورة بسبب احتساب رموز المخرجات ورموز التفكير الداخلي.
تقدم واجهة Gemini Decisions API مسارا مختلفا يعتمد على نموذج Gemini Decision 1 الذي يحمل المعرف البرمجي gemini-decision-1. بدلا من كتابة أي نص، يقوم النموذج بتقييم جميع الخيارات المرشحة في تمريرة أمامية واحدة فقط، ثم يعيد احتمالات رقمية معايرة ودرجات ثقة تتراوح قيمتها بين 0 و1، مع كون حد رموز المخرجات يساوي صفرا تماما.
وفقا لما ذكره مين تشوي مدير المنتجات وفيليكس يو كبير العلماء في Google DeepMind في إعلان جوجل الرسمي، فقد صممت هذه الواجهة خصيصا للقرارات المقيدة مثل اختيار الأدوات البرمجية، وفحص مطابقة السياسات، وتوجيه الطلبات بين النماذج المختلفة، وتقييم جودة السياق. وبفضل هذا التصميم يستطيع المطور إرسال مدخل واحد متعدد الوسائط يصل حجمه إلى 256 ألف رمز، وطرح ما يصل إلى 1,000 سؤال مستقل حول هذا المدخل في طلب برمجي واحد.
كيف يعمل الطلب داخل نموذج Gemini Decision 1؟
يتكون الطلب البرمجي الموجه إلى نقطة الاتصال POST https://generativelanguage.googleapis.com/v1beta/decisions من جزأين رئيسيين هما المدخل المشترك وقائمة الأسئلة. ويتطلب تشغيل الواجهة استخدام الإصدار 3.2 أو أحدث من حزمة تطوير البرمجيات google-genai للغة بايثون أو @google/genai للغة جافاسكريبت، مع تحديد إصدار الواجهة v1beta واستدعاء الدالة client.decisions.create وتمرير اسم النموذج gemini-decision-1 والمدخل والأسئلة، علما بأن حقل المدخل يستخدم نفس تنسيق كتل المحتوى المستخدم في واجهة Interactions API.
توضح وثائق جوجل الرسمية أن الأسئلة المرسلة في الطلب الواحد يتم تقييمها بالتوازي وفي عزلة تامة عن بعضها البعض. هذا يعني أن الأسئلة لا ترى بعضها إطلاقا، وإضافة سؤال جديد أو حذف سؤال قديم من القائمة لا يغير أبدا في نتائج أو احتمالات الأسئلة الأخرى. كما أن النموذج لا يرى المفاتيح البرمجية الخاصة بالأسئلة في الكود، ولذلك يجب كتابة السؤال كاملا وبوضوح داخل نص التعليمات الخاص بكل سؤال.
تدعم الواجهة ثلاثة أنواع محددة من الأسئلة لتغطية مختلف سيناريوهات العمل البرمجية:
- أسئلة القبول أو الرفض (noul): تعيد احتمالا رقميا للإجابة بنعم أو لا مع إمكانية إضافة معايير اختيارية لحالتي الصواب والخطأ، وتقع قيمة الاحتمال دائما في النطاق بين 0.01 و0.99.
- أسئلة الاختيار من متعدد (choice): تقبل من خيارين إلى 255 خيارا، وتعيد الخيار الفائز مع الاحتمالات الموزونة لباقي الخيارات. يتم ترتيب الخيارات أبجديا حسب المفتاح البرمجي قبل التقييم، ومجموع الاحتمالات يساوي 1 دائما حتى لو لم يكن أي خيار مناسبا للمدخل.
- أسئلة التقييم المتدرج (score): تعتمد على مقياس مرتب يبدأ من المستوى 0 ويقبل من مستويين إلى 255 مستوى، وتوصي الوثائق باستخدام ما بين مستويين إلى 10 مستويات، حيث يعيد النموذج درجة مستمرة تمثل المتوسط المرجح بالاحتمالات لمؤشرات المستويات بالإضافة إلى احتمالات كل مستوى على حدة.
يرفق النموذج مع كل إجابة درجة ثقة تساعد الكود البرمجي على اتخاذ القرار السليم. في أسئلة الاختيار والتقييم تساوي درجة الثقة احتمال النتيجة الأعلى، بينما في أسئلة نعم أو لا تساوي القيمة الأكبر بين احتمال الإيجاب واحتمال السلب، وهو ما يسمح للمطور بتحويل الحالات الغامضة تلقائيا إلى مراجعة بشرية أو مسار بديل.
دعم الوسائط المتعددة وحدود الملفات في الطلب الواحد
من النقاط القوية في هذه الواجهة قدرتها على استيعاب وسائط متعددة ومختلطة داخل نفس المدخل المشترك دون الحاجة إلى خدمات وسيطة لتفريغ الصوت أو قراءة النصوص من الصور. يمكنك مثلا إرسال تسجيل صوتي لمكالمة عميل مع البيانات الوصفية لحسابه النصي، أو إرسال ملف PDF ممسوح ضوئيا لطلب استرجاع بضاعة مرفقا به صور التلف في طلب واحد ليقوم النموذج بتقييمها جميعا دفعة واحدة.
تقبل الواجهة خمسة أنواع من المدخلات تشمل النصوص، والصور بصيغ png وjpeg وwebp وheic وheif وgif وbmp وtiff، والملفات الصوتية بصيغ wav وmp3 وaac وogg وflac وm4a وopus وغيرها، ومقاطع الفيديو بصيغ mp4 وmpeg وmov وavi وwebm وغيرها، بالإضافة إلى مستندات PDF. وفي المقابل تظل تعليمات الأسئلة نفسها نصية فقط، ويشترك المدخل مع جميع الأسئلة في نافذة سياق إجمالية تبلغ 262,144 رمزا.
من ناحية الأحجام وطرق الإرسال، تسمح الواجهة بتمرير الملفات مباشرة بترميز base64 بحجم يصل إلى 100 ميجابايت للطلب الواحد وبحد أقصى 50 ميجابايت لملفات PDF، أو عبر روابط Files API، أو من خلال روابط HTTPS عامة أو موقعة بحجم يصل إلى 15 ميجابايت لكل رابط خارجي. كما تتيح للمطور التحكم في دقة معالجة الصور والفيديو عبر أربعة مستويات هي low وmedium وhigh وultra_high، علما بأن المستوى الفائق ultra_high مخصص للصور فقط، مما يمنحك مرونة كبيرة في الموازنة بين دقة التفاصيل وتكلفة الرموز المستهلكة.
ماذا تقول جوجل عن السرعة والدقة والاستخدامات الداخلية؟
بحسب بيانات جوجل المنشورة في مدونتها الرسمية، يبلغ زمن الاستجابة الكلي للواجهة من البداية إلى النهاية ما بين 150 و250 مللي ثانية، بينما يتراوح الوسيط الحسابي لزمن معالجة النموذج نفسه بين 50 و100 مللي ثانية عبر المدخلات متعددة الوسائط والسياقات التي تصل إلى 16 ألف رمز. وتذكر جوجل أن زمن الاستجابة يظل شبه ثابت سواء تضمن الطلب سؤالا واحدا أو 100 سؤال في نفس التمريرة.
وتقول جوجل إنه في حزمة اختبارات القياس الخاصة بها، والتي تغطي توجيه الوكلاء والاستدلال والترتيب والفهم متعدد الوسائط، يتصدر نموذج Gemini Decision 1 النتائج بأقل نسبة خطأ في معايرة الاحتمالات. كما تدعي جوجل أنه نظرا لعدم احتساب أي رسوم على رموز المخرجات، فإن استخدام هذا النموذج أقل تكلفة بنحو 5 مرات عبر حزمة الاختبارات المشتركة مقارنة باستخدام نموذج Gemini 3.5 Flash-Lite مع واجهة Interactions API.
ولتوضيح كيف تعمل التقنية في بيئات الإنتاج الضخمة، أشارت جوجل إلى أربعة استخدامات داخلية تعتمد حاليا على هذا النموذج داخل منتجاتها:
- يستخدمه تطبيق Gemini Notebook كموجه فوري لاختيار فئة النموذج ومستوى التفكير المناسب، مما ساهم بحسب جوجل في خدمة الاستفسارات اليومية بزمن استجابة أقل بنسبة تصل إلى 40 بالمئة.
- تعتمد عليه تجربة Stitch للنماذج الأولية السريعة لتوليد مخططات تفاعلية وتطبيق التعديلات الصوتية أو اللمسية بشكل شبه لحظي.
- يستخدمه مشروع CC من Google Labs لاختيار تفاعل مناسب من بين أكثر من 200 رمز تعبيري في جزء من الثانية.
- يستخدمه محرك بحث جوجل كطبقة أمان لأدوات بروتوكول MCP لرصد السلوكيات العدائية ومحاولات التلاعب.
إلى جانب ذلك، وفرت جوجل تطبيقات تجريبية لاستعراض قدرات النموذج تشمل Decisions Playground وDoorstep Parcels وSpeed Sketch وFind the Zoo Keeper، مع أدلة برمجية للغات بايثون وجافاسكريبت وواجهات REST. كما بدأ طرح تكاملات برمجية مع أدوات شائعة في مجتمع المطورين مثل OpenRouter وLangChain وVercel وLiteLLM وPydantic AI وPipecat وLiveKit وOpenCode إلى جانب حزم google-genai، مع الإشارة إلى أن دعم Gemini في Google Cloud قادم قريبا.
أسعار الخدمة والباقة المجانية وحدود الاستخدام
يتميز هيكل التسعير الذي أعلنته جوجل بالبساطة والوضوح، إذ تبلغ التكلفة في الباقة المدفوعة 0.10 دولار أمريكي فقط لكل مليون رمز مدخل لجميع أنواع الوسائط من نصوص وصور وفيديو وصوت وملفات PDF، بينما تبلغ تكلفة رموز المخرجات 0 دولار. ولا توجد أي فواتير إضافية لرموز التفكير أو رسوم منفصلة لتفريغ المقاطع الصوتية أو التعرف الضوئي على الحروف في المستندات.
الميزة المالية الأهم هنا هي أن المدخل المشترك يحتسب في الفاتورة مرة واحدة فقط لكل طلب بغض النظر عن عدد الأسئلة المرفقة معه، ويضيف كل سؤال فقط عدد الرموز الخاصة بتعليماته ومعاييره النصية. ولتوضيح التكلفة بحساباتنا التقديرية، لنفترض أن موقعك يرسل طلبا يتضمن 2,000 رمز مدخل شامل للمحتوى والأسئلة، وينفذ 100,000 طلب شهريا؛ هذا يعادل 200 مليون رمز مدخل في الشهر، أي أن الفاتورة الشهرية ستبلغ نحو 20 دولارا أمريكيا فقط على الباقة المدفوعة. وبفضل احتساب المدخل مرة واحدة، فإن طرح 10 أسئلة رقابية حول تعليق عميل واحد في نفس الطلب لا يضاعف تكلفة رموز التعليق عشر مرات، بل يضيف فقط رموز أسئلتك القصيرة.
توفر جوجل أيضا باقة مجانية داخل Google AI Studio لبناء النماذج الأولية والتجربة دون رسوم على المدخلات. لكن هناك فرقا جوهريا في الخصوصية يجب على كل صاحب عمل الانتباه إليه في صفحة التسعير الرسمية: البيانات المرسلة عبر الباقة المجانية تستخدم لتحسين منتجات جوجل، أما في الباقة المدفوعة فلا تستخدم بياناتك لتحسين منتجات جوجل. لذلك ننصح في رأينا بتفعيل الباقة المدفوعة فور الانتقال من التجربة إلى التشغيل الفعلي على بيانات العملاء.
أما عن حدود معدل الاستخدام فهي تطبق على مستوى كل مشروع، وتتم إعادة ضبط الحد اليومي للطلبات في منتصف الليل بتوقيت المحيط الهادئ، مع تنبيه جوجل بأن هذه الحدود غير مضمونة بشكل مطلق:
- الباقة المجانية (Free): تسمح بحد أقصى 200 طلب في الدقيقة، و50,000 رمز في الدقيقة، و10,000 طلب في اليوم.
- المستوى الأول (Tier 1): يرفع الحد إلى 1,500 طلب في الدقيقة، ومليون رمز في الدقيقة، و50,000 طلب في اليوم.
- المستوى الثاني (Tier 2): يتيح 5,000 طلب في الدقيقة، و4 ملايين رمز في الدقيقة، مع عدد غير محدود من الطلبات اليومية.
- المستوى الثالث (Tier 3): يصل إلى 15,000 طلب في الدقيقة، و10 ملايين رمز في الدقيقة، وعدد غير محدود من الطلبات اليومية.
وبالنسبة للتوفر الجغرافي في منطقتنا العربية، فإن قائمة المناطق المتاحة لواجهة Gemini API ومنصة Google AI Studio تشمل مصر والمملكة العربية السعودية والإمارات العربية المتحدة والكويت وقطر والأردن والمغرب. ومع ذلك، لم تنشر جوجل قائمة مناطق مخصصة لنموذج القرارات وحده أو تفاصيل حول إقامة البيانات المحلية، كما أن الدعم على منصة Google Cloud لا يزال مدرجا تحت وصف قريبا دون تحديد موعد إطلاق رسمي أو اتفاقية مستوى خدمة.
أبرز المميزات والعيوب من منظور عملي
عند تقييم هذه الخدمة لأصحاب المواقع والمطورين، نجد أنها تقدم توازنا واضحا بين السرعة والتكلفة مقابل قيود محددة في طبيعة المخرجات. فهم هذه الجوانب يساعدك على توظيف الأداة في مكانها الصحيح دون تحميلها مهام خارج نطاقها.
تتمثل أبرز المميزات العملية في النقاط التالية:
- تقييم ما يصل إلى 1,000 سؤال معزول بالتوازي في تمريرة واحدة مع احتساب تكلفة المدخل المشترك مرة واحدة فقط.
- قبول النصوص والصور والصوت والفيديو وملفات PDF معا في نفس الطلب وبسعر موحد يبلغ 0.10 دولار لكل مليون رمز مدخل في الباقة المدفوعة.
- انعدام رسوم المخرجات تماما، مما يجعل التكلفة قابلة للتوقع بدقة قبل إرسال الطلب بناء على حجم المدخلات فقط.
- الحصول على احتمالات رقمية معايرة ودرجات ثقة صريحة تسهل برمجة قواعد التحويل التلقائي أو المراجعة البشرية.
في المقابل، تتلخص أبرز العيوب التي يجب وضعها في الحسبان في الآتي:
- لا يقدم النموذج أي تفسير نصي لسبب اتخاذه القرار، فإذا رفض صورة أو تعليقا لن يكتب لك جملة تشرح السبب ما لم تطرح أسئلة تفصيلية منفصلة لكل معيار.
- غياب ميزة التخزين المؤقت للسياق وغياب واجهة المعالجة المجمعة Batch API حاليا، مما يعني أن تكرار إرسال نفس المدخل في طلبات منفصلة يحتسب بالتكلفة الكاملة في كل مرة.
- تقتصر الخدمة حاليا على إصدار المطورين التجريبي v1beta ولا تتوفر بعد على Google Cloud للشركات التي تشترط بيئة سحابية مؤسسية متكاملة.
مقارنة مع البدائل لدى OpenAI وAnthropic
لم تعد جوجل وحدها في مضمار واجهات القرارات المخصصة، إذ سبق أن شرحنا في مقالنا السابق حول واجهة OpenAI Decisions API كيف اتجهت الشركات الكبرى لفصل مهام التصنيف عن مهام التوليد النصي. وبمقارنة الوثائق الرسمية للخدمتين، نجد أن واجهة OpenAI متاحة بشكل عام عبر نقطة الاتصال POST /v1/decisions وتعمل حصريا بنموذج gpt-6-luna، وتقول OpenAI إنها أسرع بنحو 10 مرات من واجهة Responses API الخاصة بها.
تتفق واجهة OpenAI مع واجهة جوجل في السعر الأساسي للمدخلات غير المخزنة مؤقتا وهو 0.10 دولار لكل مليون رمز مع عدم فرض أي رسوم على رموز المخرجات، كما تقدم ثلاثة أنواع متشابهة من الأسئلة هي predicate وchoice وscore. لكن الفروق الجوهرية تظهر في سعة الأسئلة ونوع الوسائط والتخزين المؤقت؛ فواجهة OpenAI تقبل من سؤال واحد إلى 400 سؤال في الطلب وتدعم النصوص والصور وبيانات JSON وسجل المحادثة المتضمن استدعاءات الأدوات، وتتميز بدعم التخزين المؤقت للموجهات بتخفيضات قياسية، لكنها لا تدعم الملفات أو المقاطع الصوتية. في المقابل تتفوق واجهة جوجل بقبول الصوت والفيديو وملفات PDF وحتى 1,000 سؤال في الطلب، لكنها تفتقر للتخزين المؤقت حاليا.
توجد أيضا طرق أخرى للتصنيف في السوق عبر النماذج التوليدية، مثل ميزة المخرجات المنظمة Structured Outputs من OpenAI التي تلزم النموذج بإرجاع استجابة تتبع مخطط JSON Schema محدد بما في ذلك القوائم الثابتة enums، وكذلك الوصفة البرمجية المؤرشفة في دليل OpenAI التي تستخدم معامل logprobs في واجهة Chat Completions لاستخراج احتمالات الفئات. وعلى نفس المنوال توفر شركة Anthropic ميزة المخرجات المنظمة لتقييد إجابات نماذج Claude بمخطط JSON مع التحقق الصارم من أسماء ومدخلات الأدوات، لكن وثائق Anthropic لا تتضمن نقطة اتصال مخصصة للقرارات، مما يعني أن طلباتها تظل عمليات توليدية تنتج رموز مخرجات مدفوعة.
من المهم التأكيد هنا على أنه لم نجد حتى الآن أي اختبارات قياس مستقلة منشورة تقارن وجها لوجه بين أداء أو سرعة أو دقة نموذج Gemini Decision 1 ونموذج gpt-6-luna من OpenAI، ولذلك تظل أرقام السرعة والدقة المذكورة منسوبة لكل شركة على حدة. وفي رأينا، فإن الكفة تميل لصالح واجهة جوجل إذا كان تطبيقك يعتمد على فحص ملفات PDF أو مقاطع صوتية أو فيديوهات، بينما تمنحك واجهة OpenAI ميزة اقتصادية مهمة إذا كنت تكرر إرسال نفس السياق الطويل عبر طلبات منفصلة بفضل دعمها للتخزين المؤقت.
متى تستخدم هذه الواجهة ومتى تختار نموذجا توليديا؟
تضع وثائق جوجل قاعدة فصل واضحة لمساعدة المطورين في اختيار الأداة المناسبة لكل مهمة داخل النظام البرمجي. القاعدة البسيطة هي أن تستخدم واجهة القرارات عندما تكون جميع النتائج المحتملة معروفة مسبقا وتريد الحصول على احتمالات رقمية معايرة لاختيار مسار برمجي محدد، مثل تصنيف رسالة، أو تقييم جودة صورة على مقياس من خمس درجات، أو فحص ما إذا كان النص يخالف سياسة معينة.
أما عندما يحتاج تطبيقك إلى كتابة نصوص موجهة للمستخدم، أو استخراج بيانات حرة داخل مخطط JSON مخصص، أو تنفيذ استدعاءات دوال برمجية تتطلب تمرير معاملات ومتغيرات، أو إجراء تفكير واستدلال متعدد الخطوات، فهنا توجهك وثائق جوجل لاستخدام واجهة Interactions API مع النماذج التوليدية. في هذه الحالات التوليدية يمكنك الاعتماد على نماذج قوية تناولناها بالتفصيل مثل نموذج Gemini 4 Carbon للمهام المعقدة والاستدلال العميق، أو اختيار نموذج Gemini Omni 1.2 Flash عندما تحتاج إلى توليد نصوص واستجابات سريعة بتكلفة اقتصادية.
في رأينا، وفي كثير من المشاريع العملية، يكون الحل الأفضل هو الجمع بين النوعين في خط عمل واحد. يقوم نموذج القرارات أولا بدور الحارس والموجه السريع بتكلفة لا تذكر، فيحدد نوع طلب العميل ومدى التزامه بالسياسات في أجزاء من الثانية، ثم يوجه الطلب فقط عند الحاجة إلى النموذج التوليدي المناسب لصياغة الرد النهائي.
القيود التقنية الحالية وأفضل الممارسات البرمجية
قبل كتابة أول سطر برمجي لربط الواجهة بموقعك، يجب الإحاطة بمجموعة من القيود التقنية المنصوص عليها في وثائق نموذج gemini-decision-1. النموذج لا يدعم إطلاقا توليد النصوص، أو المخرجات المنظمة، أو استدعاء الدوال، أو التفكير، أو الربط المباشر بنتائج بحث جوجل، أو التخزين المؤقت للسياق، أو واجهات Batch API وLive API، أو خيارات التنفيذ المرن وذي الأولوية Flex وPriority inference.
وعلى مستوى المدخلات، لا تقبل الواجهة روابط يوتيوب أو روابط التخزين السحابي gs:// URIs، كما لا تقبل تمرير سجل المحادثات أو كتل التفكير أو كتل استدعاء الأدوات كعناصر برمجية مباشرة، بل يجب تحويلها إلى نصوص عادية أولا قبل الإرسال. وفي حال إرسال مدخل ينتهك معايير السلامة، ترفض الواجهة الطلب وتعيد رمز الخطأ HTTP 400 مرفقا بكود خطأ أمان. كما نلفت الانتباه إلى أن جوجل لم تنشر أي أرقام قياس خاصة بدقة النموذج أو معايرته في اللغة العربية تحديدا.
وللحصول على أدق نتائج ممكنة وتفادي الأخطاء الشائعة، توصي وثائق جوجل باتباع مجموعة من الممارسات البرمجية الدقيقة عند صياغة الأسئلة:
- تقسيم السياسات المعقدة إلى أسئلة ذرية: بدلا من طرح سؤال واحد مركب يحتوي على عدة شروط، اطرح كل شرط في سؤال مستقل ثم اجمع النتائج بمنطق برمجي داخل الكود، واستخدم الصياغة الإيجابية المباشرة.
- معالجة فخ المجموع الكلي في أسئلة الاختيار: بما أن احتمالات خيارات choice تجمع دائما إلى 1 حتى لو لم يناسب أي خيار المدخل، استخدم عتبة ثقة رقمية، أو أضف سؤال نعم أو لا منفصلا للتحقق من النطاق أولا، أو أضف خيارا شاملا باسم other وتجنب تسميته none_of_the_above.
- التعامل مع مدخلات المستخدم كبيانات غير موثوقة: يمكن للمستخدمين كتابة نصوص تحاول خداع النموذج وإقناعه بتصنيف معين، لذلك أرسل فقط الحقول الضرورية، ونفذ مقارنات الأرقام والتواريخ بالكود البرمجي العادي، واضبط عتبات الثقة بناء على أمثلة مصنفة من بيانات موقعك الفعلية مع إبقاء مراجعة بشرية للقرارات الحساسة.
كيف تستفيد مواقع ووردبريس ومتاجر ووكومرس من هذه التقنية؟
نود التوضيح منذ البداية أن جوجل لم تذكر أي إضافة ووردبريس أو ووكومرس للربط مع واجهة القرارات، ولم نعثر على إضافة جاهزة حتى لحظة كتابة هذا المقال. وفي رأينا، فإن غياب الإضافات الجاهزة لا يمنع أصحاب المواقع من الاستفادة منها اليوم، لأن بنية الواجهة البسيطة عبر طلبات REST تجعل بناء تكامل مخصص أمرا ممكنا لمطور ووردبريس متمكن.
من واقع خبرتنا في تطوير المواقع، هناك قواعد معمارية أساسية يجب الالتزام بها عند برمجة هذا الربط داخل ووردبريس. يجب حفظ مفتاح الواجهة البرمجية API key على الخادم فقط وعدم كشفه أبدا في كود المتصفح الأمامي، مع استخدام الباقة المدفوعة لحماية خصوصية بيانات العملاء. والأهم هو عدم استدعاء الواجهة بشكل يعطل تحميل الصفحة أمام الزائر، بل يتم تنفيذ الطلبات في الخلفية عبر خطافات الخادم أو جدولة المهام غير المتزامنة مثل Action Scheduler المدمج في ووكومرس.
في رأينا، يمكن توظيف هذه الواجهة في أربعة سيناريوهات عملية عالية القيمة لأصحاب الأعمال في منطقتنا العربية:
- فلترة التعليقات ورسائل نماذج التواصل: بدلا من الاعتماد على فلاتر الكلمات التقليدية، يمكن للموقع إرسال نص التعليق أو الرسالة في الخلفية مع خمسة أو ستة أسئلة من نوع noul وchoice لفحص الرسائل الترويجية المزعجة، واكتشاف الإساءة، وتحديد ما إذا كانت الرسالة طلب شراء حقيقي يستحق تنبيه فريق المبيعات فورا.
- توجيه تذاكر الدعم الفني والمساعدات الذكية: عند بناء شات بوت بالذكاء الاصطناعي في ووردبريس، يمكن وضع نموذج القرارات في الخطوة الأولى ليحدد في أجزاء من الثانية هل استفسار العميل يتعلق بالشحن أم الفواتير أم الأعطال التقنية، وهل يحتاج إلى نموذج توليدي بسيط أم إلى تحويل فوري لموظف خدمة العملاء.
- فحص جودة صور المنتجات وتقييمات المشترين في ووكومرس: في المتاجر متعددة البائعين أو ذات الكتالوجات الكبيرة، يمكن إرسال صورة المنتج الجديدة مع أسئلة لفحص وضوح الإضاءة، وخلو الصورة من العلامات المائية المخالفة، ومطابقتها لقسم المنتج. ومع تزايد أهمية جودة بيانات المتجر لظهور الأعمال والمتاجر داخل ChatGPT ومنصات التسوق الذكية، يساعدك هذا الفحص الآلي، الذي يمكن أن يبرمجه لك مطور ووكومرس محترف، في الحفاظ على كتالوج منتجات نظيف وموثوق دون مجهود يدوي مرهق.
- تطبيق عتبات الثقة والمراجعة البشرية في لوحة التحكم: البرمجة السليمة لا تترك القرار النهائي للنموذج في كل الحالات؛ فعلى سبيل المثال، إذا أعاد النموذج درجة ثقة تزيد على 0.90 بأن التقييم سليم يتم نشره تلقائيا، وإذا كانت الثقة عالية بأنه مخالف يتم حجبه، أما إذا وقعت درجة الثقة في المنطقة الرمادية بين 0.50 و0.89 فيقوم الكود بوضع التقييم في قائمة انتظار خاصة داخل لوحة تحكم ووردبريس ليراجعه مشرف بشري بنقرة واحدة، على أن تضبط هذه العتبات بناء على أمثلة حقيقية من موقعك كما توصي جوجل.
إذا كنت تدير موقعا أو متجرا إلكترونيا وتفكر في أتمتة عمليات المراجعة والتصنيف وتوجيه طلبات العملاء بطريقة توفر الوقت وتضبط التكاليف، يمكنك استكشاف خدماتنا في تطوير مواقع ووردبريس المخصصة للأعمال، أو حجز استشارة مجانية معنا لدراسة احتياجات موقعك وتصميم الحل البرمجي الأنسب لميزانيتك وأهدافك.
الأسئلة الشائعة
ما هي واجهة Gemini Decisions API وهل تتوفر لها إضافة جاهزة في ووردبريس؟
هي واجهة برمجية أطلقتها شركة جوجل في نوفمبر 2026 وتعتمد على نموذج Gemini Decision 1 لاتخاذ قرارات محددة مسبقا عبر إرجاع احتمالات رقمية ودرجات ثقة بدلا من كتابة نصوص. تستخدم الواجهة في مهام مثل تصنيف المحتوى وتوجيه التذاكر وفحص السياسات عبر تمريرة واحدة سريعة. وحتى الآن لم تذكر جوجل أي إضافة جاهزة لمواقع ووردبريس أو متاجر ووكومرس ولم نعثر على إضافة منشورة، لذلك يتطلب استخدامها برمجة ربط مخصص على الخادم عبر واجهة المطورين.
ما الفرق بين هذه الواجهة وبين النماذج التوليدية المعتادة في عائلة جيميني؟
النموذج التوليدي المعتاد يقرأ المدخلات ثم يكتب إجابة نصية كلمة بكلمة ويحاسبك على رموز المخرجات، وهو مناسب لكتابة المقالات أو الرد على العملاء. أما نموذج القرارات الجديد فلا يولد أي نص على الإطلاق وحد المخرجات فيه يساوي صفرا، بل يقيم ما يصل إلى ألف سؤال منفصل حول مدخل واحد في تمريرة واحدة ويعيد احتمالات رقمية بين الصفر والواحد. هذا الأسلوب يوفر سرعة أعلى وتكلفة أقل عندما تحتاج فقط إلى اختيار قرار من قائمة مغلقة.
كم تبلغ تكلفة الاستخدام وما الفرق بين الباقة المجانية والمدفوعة؟
تبلغ التسعيرة في الباقة المدفوعة عشر سنتات فقط لكل مليون رمز مدخل لجميع أنواع الوسائط، ولا توجد أي رسوم على المخرجات أو التفكير أو تفريغ الصوت. وعند إرسال عدة أسئلة على نفس المدخل يتم احتساب رموز المدخل المشترك مرة واحدة فقط مع إضافة رموز تعليمات كل سؤال. وتوفر جوجل باقة مجانية للتجربة، لكن بيانات الباقة المجانية تستخدم في تحسين منتجات جوجل بينما لا تستخدم بيانات الباقة المدفوعة لهذا الغرض.
بماذا تختلف واجهة جوجل عن واجهة القرارات المنافسة من شركة OpenAI؟
تتفق الخدمتان في السعر الأساسي للمدخلات وهو عشر سنتات لكل مليون رمز دون رسوم على المخرجات، لكنهما تختلفان في الوسائط المدعومة والتخزين المؤقت. واجهة جوجل تقبل النصوص والصور والصوت والفيديو وملفات PDF وتسمح بطرح ألف سؤال في الطلب الواحد دون دعم التخزين المؤقت حاليا. أما واجهة OpenAI فتعمل بنموذج gpt-6-luna وتدعم النصوص والصور وبيانات JSON وسجل المحادثة حتى أربعمئة سؤال مع دعم التخزين المؤقت، لكنها لا تقبل الصوت أو الملفات.
كيف يمكن لصاحب موقع ووردبريس أو متجر ووكومرس الاستفادة منها عمليا؟
في رأينا يمكن لمطور ووردبريس ربط الواجهة في خلفية الموقع لفحص التعليقات والرسائل المزعجة وتوجيه تذاكر الدعم الفني ومراجعة صور وتقييمات المنتجات في ووكومرس تلقائيا. يرسل الموقع المحتوى مع عدة أسئلة رقابية في طلب واحد، ثم يعتمد الكود البرمجي على درجة الثقة لاتخاذ الإجراء المناسب. فإذا كانت درجة الثقة مرتفعة يتم قبول المحتوى أو رفضه فورا، وإذا كانت متوسطة يحول إلى مراجعة بشرية في لوحة التحكم لضمان الدقة.
المراجع
- Google Blog: Gemini Decisions API: Fast, calibrated multimodal decisions
- Google AI Studio Documentation: Decisions API
- Google AI Studio Documentation: Gemini Decision 1 Model
- Google AI Studio Documentation: Gemini Developer API Pricing
- Google AI Studio Documentation: Rate Limits
- Google AI Studio Documentation: Available Regions
- OpenAI Developer Documentation: Decisions API Guide
- OpenAI Developer Documentation: Structured Outputs Guide
- OpenAI Cookbook: Using Logprobs
- Anthropic Claude Documentation: Structured Outputs