This article is available in English — Read in English
يعالج إصدار GPT-Live-1.1 في OpenAI API الذي أطلقته الشركة في 19 نوفمبر 2026 مشكلتين تشغيليتين كانتا تعطلان التوسع في المساعدات الصوتية الحية داخل بيئات العمل الفعلية: دقة فهم الكلام عند خلط اللغات أثناء الحوار المباشر، والتكلفة المستمرة لاتصالات WebRTC خلال فترات صمت العميل. يتوفر النموذج الجديد تحت المعرف gpt-live-1.1 (وبالنسخة الافتراضية gpt-live-1.1) حصريا على المسار البرمجي v1/live/sessions، ويركز على تطوير التفاعل الصوتي المزدوج المتزامن مع تبسيط طريقة تمرير الاستعلامات المعقدة وعمليات قواعد البيانات إلى خدمات الخلفية.
وبالتوازي مع طرح هذا النموذج، أضافت OpenAI ميزة وضع الانتظار القابل للضبط عبر WebRTC لكل من gpt-live-1 و gpt-live-1.1، مما يقلص تكلفة الدقيقة خلال فترات التوقف المؤقت من 0.05 دولار للدقيقة إلى 0.02 دولار للدقيقة. بالنسبة للشركات في مصر والسعودية والإمارات وسائر أسواق المنطقة العربية التي تدير منصات خدمات على ووردبريس أو متاجر ووكومرس أو مراكز اتصال هاتفية عبر بروتوكول SIP، يغير هذان التحديثان حسابات الميزانية وطريقة تصميم الواجهات الصوتية ثنائية اللغة من الأساس.
ما الجديد في إصدار GPT-Live-1.1 في OpenAI API ولماذا يهم السوق العربي
يعمل نموذج gpt-live-1.1 مثل الجيل السابق له بنظام الاتصال المزدوج الكامل (Full-Duplex)، أي أنه يستمع إلى المتصل ويتحدث في الوقت نفسه دون انتظار انتهاء الطرف الآخر عبر فواصل جامدة. يراقب النموذج تدفق الصوت الوارد باستمرار، ويتعامل مع التداخل الطبيعي في الحوار البشري، ويتوقف فورا عن الكلام عندما يقاطعه العميل أو يصحح معلومة في منتصف الجملة.
غير أن التفوق الفعلي لنموذج gpt-live-1.1 مقارنة بنموذج gpt-live-1 يظهر في كفاءة الواجهة الصوتية واللغوية من جهة، وفي نظافة صياغة تعليمات التفويض للخلفية من جهة أخرى. وفقا لسجل تحديثات OpenAI الرسمي ووثائق النموذج الصادرة في 19 نوفمبر 2026، يرتكز التحديث على أربع قدرات موثقة:
- دقة أعلى في تفريغ الكلام المنطوق: يقلل التحسن في تحويل الصوت إلى نص داخل الجلسة من أخطاء التقاط أرقام الطلبات وأرقام الهواتف والمصطلحات التخصصية قبل إرسالها إلى أي أداة برمجية أو نموذج استنتاج في الخلفية.
- نطق أفضل للمفردات متعددة اللغات: يتعامل المخرج الصوتي مع الكلمات غير الإنجليزية والجمل التي تجمع بين لغتين بصورة طبيعية، مما يمنع النطق الآلي المشوه عندما ينتقل الحوار بين العربية والإنجليزية.
- ثبات أقوى للهجة وهوية الصوت عبر اللغات: عندما يغير المتصل لغة الحديث في منتصف المكالمة، يحافظ
gpt-live-1.1على نفس البصمة الصوتية ونبرة المتحدث بدلا من أن يبدو وكأنه شخص مختلف تماما مع كل جملة بلغة أخرى. - صياغة قواعد التفويض باللغة الطبيعية: لم يعد المطورون مضطرين إلى تضمين رمز
<|SpawnThinking|>الخاص بنموذجgpt-live-1لتحفيز استدعاء الخلفية، بل يكفي كتابة شروط صريحة وواضحة تحت عنوانيDelegate to the backend when:وDo not delegate when:.
في واقع خدمة العملاء اليومي داخل المنطقة العربية، يحل الجمع بين دقة التفريغ وثبات الصوت عبر اللغات مشكلة متكررة كانت تسبب إحباطا للمستخدمين. العميل الذي يتصل بمتجر إلكترونيات في القاهرة أو يحجز موعدا في عيادة أسنان في دبي أو يستفسر عن شحنة في الرياض نادرا ما يتحدث بعربية فصحى خالصة أو إنجليزية خالصة طوال المكالمة. في الأغلب يبدأ سؤاله بالعربية، ثم ينطق اسم العلامة التجارية أو كود المنتج SKU أو اسم المجمع السكني بالإنجليزية، ثم يعود للعربية للسؤال عن رسوم الدفع عند الاستلام أو مواعيد التوصيل.
مع النماذج الصوتية الأقدم، كان هذا التبديل السريع يؤدي إما إلى تحريف كود المنتج أثناء التفريغ النصي فيفشل البحث في قاعدة البيانات، وإما إلى تغير مفاجئ وحاد في خامة الصوت عند نطق المصطلح الإنجليزي. تحسين هاتين النقطتين في gpt-live-1.1 يجعل التجربة الصوتية أقرب بكثير لموظف خدمة عملاء محلي يفهم سياق السوق.
نطاق المسار البرمجي وبنية جلسات المحادثة الحية
قبل البدء في تخطيط الترقية أو بناء إضافة جديدة لموقعك، هناك قيد معماري صارم يجب على فريق التطوير الانتباه إليه: نموذج gpt-live-1.1 مدعوم فقط وحصريا عبر المسار البرمجي v1/live/sessions. لا يمكنك استدعاء هذا النموذج عبر مسار v1/chat/completions، أو v1/responses، أو v1/realtime، أو v1/audio/speech، أو v1/audio/transcriptions.
هذا الفصل المعماري مقصود تماما من جانب OpenAI. مسار v1/live/sessions مصمم لإدارة حلقات محادثة مستمرة تحفظ الحالة (Stateful) وتدعم تدفق الصوت منخفض الكمون بالتوازي مع تفويض المهام غير المتزامن للخلفية. لذلك فإن وضع المعرف gpt-live-1.1 داخل طلب نصي تقليدي أو اتصال Realtime قديم سيعيد رسالة خطأ مباشرة تفيد بعدم دعم المسار.
| البعد التقني | نموذج gpt-live-1 | نموذج gpt-live-1.1 |
|---|---|---|
| المسار البرمجي المدعوم | v1/live/sessions فقط | v1/live/sessions فقط |
| أنماط الإدخال والإخراج | إدخال صوتي ونصي، وإخراج صوتي ونصي | إدخال صوتي ونصي، وإخراج صوتي ونصي |
| الميزات البرمجية المدعومة | streaming و function_calling | streaming و function_calling |
| صيغة تعليمات التفويض للخلفية | صيغة الرمز الخاص <|SpawnThinking|> | قواعد اللغة الطبيعية Delegate to the backend when: و Do not delegate when: |
| الكلام متعدد اللغات والتفريغ النصي | المستوى الأساسي للتفريغ والتعامل الصوتي المباشر | تفريغ كلام أدق، ونطق أفضل للغات المتعددة، وثبات أقوى للهجة والصوت عبر اللغات |
| حدود الجلسات المتزامنة (Rate Limits) | حصة جلسات متزامنة خاصة بنموذج gpt-live-1 عبر مناطق المعالجة | حدود جلسات متزامنة منفصلة ومستقلة عن gpt-live-1 تطبق عبر مناطق المعالجة |
| تسعير WebRTC النشط ووضع الانتظار | 0.05 دولار/دقيقة نشط، و 0.02 دولار/دقيقة انتظار WebRTC (أضيف في 19 نوفمبر 2026) | 0.05 دولار/دقيقة نشط، و 0.02 دولار/دقيقة انتظار WebRTC |
تمنحك استقلالية حدود الجلسات المتزامنة (Concurrent-Session Rate Limits) بين gpt-live-1.1 و gpt-live-1 عبر مناطق المعالجة ميزة تشغيلية مهمة عند الترقية. يستطيع فريقك تطبيق نشر تدريجي (Blue-Green Deployment) بحيث تظل المكالمات الحية الحالية على gpt-live-1 بينما تختبر نسبة من الزوار على gpt-live-1.1 دون خوف من أن يستهلك النموذج الجديد حصة الاتصالات المتزامنة المخصصة للنظام القائم.
خيارات النقل: WebRTC و WebSockets ومكالمات SIP الهاتفية
يدعم مسار v1/live/sessions ثلاثة بروتوكولات نقل مختلفة بحسب مصدر الصوت وطبيعة القناة التي يتحدث منها العميل. اختيار البروتوكول المناسب منذ البداية يوفر على فريقك إعادة كتابة طبقة الاتصال عند التوسع من نافذة محادثة على الموقع إلى مركز اتصال متكامل:
- بروتوكول WebRTC (الموصى به لعملاء المتصفح وتطبيقات الهاتف والخوادم الصوتية): توصي OpenAI باستخدام WebRTC للأدوات الصوتية المدمجة في المتصفح وتطبيقات الهواتف ومسارات الصوت على الخوادم لأنه يعالج تذبذب الشبكة وفقدان الحزم والتفاوض على مسارات الصوت تلقائيا. كما أن WebRTC شرط إلزامي للاستفادة من وضع الانتظار المخفض السعر.
- بروتوكول WebSockets: يناسب حالات الربط بين خادم وآخر (Server-to-Server) أو الأنظمة الوسيطة المخصصة التي تحتاج إلى تمرير إطارات الصوت الخام وأحداث التحكم عبر بنية Sockets قائمة لديك مسبقا.
- الاتصالات الهاتفية وبروتوكول SIP: بعد إطلاق OpenAI لميزة المكالمات الهاتفية الصادرة عبر SIP على مسار
v1/live/sessionsفي 2 نوفمبر 2026، أصبح بإمكان الوكلاء الصوتيين الاتصال مباشرة بشبكات الهاتف وأنظمة السنترال PBX لإدارة المكالمات الواردة والصادرة.
في البنية العملية التي نراها ناجحة لدى الشركات المتوسطة والكبيرة في المنطقة العربية، تعمل خدمة تفويض خلفية واحدة على تغذية قناتين صوتيتين في آن واحد: زر محادثة صوتية يعمل عبر WebRTC داخل صفحات الدفع في ووكومرس أو صفحات حجز المواعيد، وخط SIP هاتفي يرد على العملاء الذين يفضلون الاتصال برقم أرضي أو موحد.
معاملات بدء الجلسة واختيار الأصوات المدمجة
عندما يبدأ تطبيقك جلسة جديدة على مسار v1/live/sessions، تحدد حمولة الإعداد الأولية (Startup Payload) هوية النموذج، وسلوك النظام، وخامة الصوت، وطريقة التفويض. وتشمل الحقول الأساسية ما يلي:
model: يضبط على القيمة"gpt-live-1.1".instructions: تعليمات النظام التي توجه النموذج الصوتي، وتتسع لما يصل إلى16,384رمزا (Tokens) عند بدء الجلسة، مع إمكانية الإضافة إليها أثناء المكالمة عبر الحدثsession.instructions.append.input: مصفوفة من الرسائل النصية السابقة لتغذية سجل المحادثة قبل بدء تدفق الصوت (القيمة الافتراضية[]).audio.output.voice: القيمة الافتراضية هي الصوتmarin. ويمكنك الاختيار من مجموعة واسعة من الأصوات الطبيعية والمولدة المدمجة تشملquartzوrippleوvesperوwillowوstoneوgleamوmeridianوbossaوtempoوbeaconوdeltaوcinderوnuriوjuniوflitzوbriseوsillageوniraوharemaوshidaوnoeul، أو إعداد أصوات مخصصة.delegation.type: يحدد نمط التفويض عند انطلاق الجلسة بين القيمة الافتراضية"client"أو القيمة"responses".store: القيمة الافتراضية هيfalse. وعند ضبطه علىstore: trueيحتفظ النظام بحالة الجلسة لتتمكن من استخدام ميزة تفريع الجلسات (Session Forking) لأغراض الاختبار وتصحيح الأخطاء وتجربة مسارات حوار بديلة.
تبرز أهمية الحقل input بشكل خاص في مواقع ووردبريس التي تبدأ فيها رحلة الزائر عبر نافذة دردشة نصية، ثم يقرر الضغط على زر التحدث الصوتي لإتمام طلبه. تمرير الرسائل النصية السابقة داخل input عند فتح الجلسة الصوتية يسمح لنموذج gpt-live-1.1 باستكمال الحوار فورا دون إزعاج العميل بإعادة ذكر اسمه أو رقم طلبه من جديد.
هندسة التعليمات باللغة الطبيعية والتحكم في السياق أثناء المكالمة
تختلف كتابة تعليمات لنموذج صوتي مزدوج الاتجاه جذريا عن كتابة تعليمات لبوت دردشة نصي. لأن النموذج الصوتي يستمع ويتكلم في نفس اللحظة وينسق مع عقل برمجي منفصل في الخلفية، فإن وضع فقرة تعليمات عامة غير منظمة يؤدي غالبا إلى مقاطعات في غير محلها، أو استدعاء مبكر للأدوات قبل اكتمال جملة العميل، أو صمت مريب ريثما ينتهي استعلام قاعدة البيانات.
في إصدار gpt-live-1.1، وضعت OpenAI إطارا قياسيا لتعليمات المحادثة الحية يعتمد على ثلاثة عناوين سياسات صريحة داخل حقل instructions (ضمن سقف 16,384 رمزا)، واستبدلت صيغة الرمز <|SpawnThinking|> الهشة بقواعد تفويض مقروءة باللغة الطبيعية.
الأقسام الثلاثة الأساسية في تعليمات الجلسة
لضمان سلوك صوتي منضبط في بيئة الإنتاج، ينبغي تقسيم تعليمات النظام في gpt-live-1.1 تحت ثلاثة عناوين واضحة تحدد للنموذج كيف يتصرف في كل موقف لحظي:
- سياسة تفاعل الاستماع (
Backchannel policy): تحدد متى وكيف يصدر النموذج إشارات استماع قصيرة ومطمئنة (مثل “نعم” أو “واضح” أو “تفضل”) أثناء سرد العميل لشرح طويل من عدة جمل، بما يؤكد للمتصل أن الخط مفتوح دون سرقة دور الحديث منه. - سياسة المقاطعة (
Interruption policy): توجه النموذج إلى كيفية التوقف الفوري عن الكلام فور مداخلة العميل، وإهمال مسار الشرح القديم الذي تجاوزه المتصل، والتركيز المباشر على التصحيح أو السؤال الجديد. - سياسة التفويض للخلفية (
Delegation policy): تنظم عملية التسليم للخلفية عبر ثلاثة عناصر فرعية مكتوبة بلغة صريحة:Backend tools(توصيف الأدوات والقدرات المتاحة خلف الكواليس)، وDelegate to the backend when(الحالات التي توجب التفويض فورا مثل فحص حالة طلب في ووكومرس أو حساب رسوم الجمارك والشحن أو تعديل موعد حجز)، وDo not delegate when(الحالات التي يجب أن يرد عليها النموذج الصوتي بنفسه دون انتظار، مثل التحية، أو طلب توضيح رقم غير مسموع، أو تكرار مواعيد العمل الموجودة أصلا في السياق).
الانتقال من الرمز <|SpawnThinking|> إلى قوائم Delegate to the backend when و Do not delegate when يجعل مراجعة التعليمات أسهل وأكثر أمانا لمديري المنتجات وفرق ضمان الجودة. بمجرد قراءة ملف التعليمات، يستطيع أي مهندس أو مسؤول أعمال معرفة الأسئلة التي ستعالج لحظيا في الحلقة الصوتية والطلبات التي ستمرر إلى الخادم الخلفي.
أحداث التحديث الفوري للسياق الصامت والتعليق الصوتي والنصوص الإلزامية
أثناء سير المكالمة، يحتاج تطبيقك في كثير من الأحيان إلى تزويد النموذج الصوتي بمعلومات جديدة ظهرت للتو أو إجباره على نطق صياغة قانونية محددة دون إعادة تشغيل الجلسة. يوفر بروتوكول الأحداث في v1/live/sessions ثلاث أدوات إلحاق متخصصة لهذا الغرض:
- الحدث
session.thinking.append: يحقن سياقا صامتا وملخصا داخل حالة المحادثة دون أن ينطقه النموذج من تلقاء نفسه. على سبيل المثال، عندما يفتح عميل مسجل الدخول في متجر ووكومرس جلسة صوتية، يستطيع خادمك إرسال فئة عضويته ولغته المفضلة ورقم آخر طلب له عبرsession.thinking.appendليكون النموذج على دراية كاملة بخلفية العميل منذ اللحظة الأولى. - الحدث
session.commentary.append: يرسل تحديثات صوتية منطوقة لإعلام المتصل بتقدم المهمة أثناء تنفيذ عملية خلفية تستغرق عدة ثوان. فإذا كان استعلام نظام المخزون ERP أو واجهة شركة الشحن يحتاج إلى أربع ثوان للرد، فإن إرسال جملة طمأنة قصيرة عبرsession.commentary.appendيملأ الفجوة الزمنية ويمنع شعور العميل بانقطاع الخط. - الحدث
session.instructions.appendمع وسم النطق الحرفي<say>: يضيف تعليمات جديدة في منتصف الجلسة ويدعم إجبار النموذج على قراءة نص محدد حرفيا. عند إرسال التوجيه القياسيRead the following exactly, without an introduction or explanation: <say>...</say>يلتزم النموذج بنطق نص إشعار تسجيل المكالمة أو شروط الاسترجاع أو تفاصيل تأكيد الدفع كلمة بكلمة دون أي ارتجال أو إعادة صياغة.
الجمع بين session.commentary.append أثناء فترات انتظار استجابة الأنظمة الخلفية ووسم <say>...</say> عند قراءة الشروط الإلزامية يعالج أكبر تحفظين لدى المؤسسات تجاه المساعدات الصوتية التوليدية: الصمت المفاجئ أثناء استدعاء قواعد البيانات، وتغيير الصياغات القانونية المعتمدة.
معمارية التفويض المزدوج: مقارنة وضع Responses ووضع Client
تقوم فلسفة واجهة Live API من OpenAI على فصل واجهة المحادثة الصوتية السريعة (gpt-live-1.1) عن عمليات الاستنتاج العميق واستعلامات قواعد البيانات ومنطق الأعمال الثقيل. لأن الحوار الصوتي يفقد طبيعيته فور ارتفاع زمن الاستجابة، يتفرغ gpt-live-1.1 لفهم الصوت لحظيا وإدارة تبادل الأدوار والرد السريع، بينما يفوض المهام الثقيلة بشكل غير متزامن إلى الخلفية.
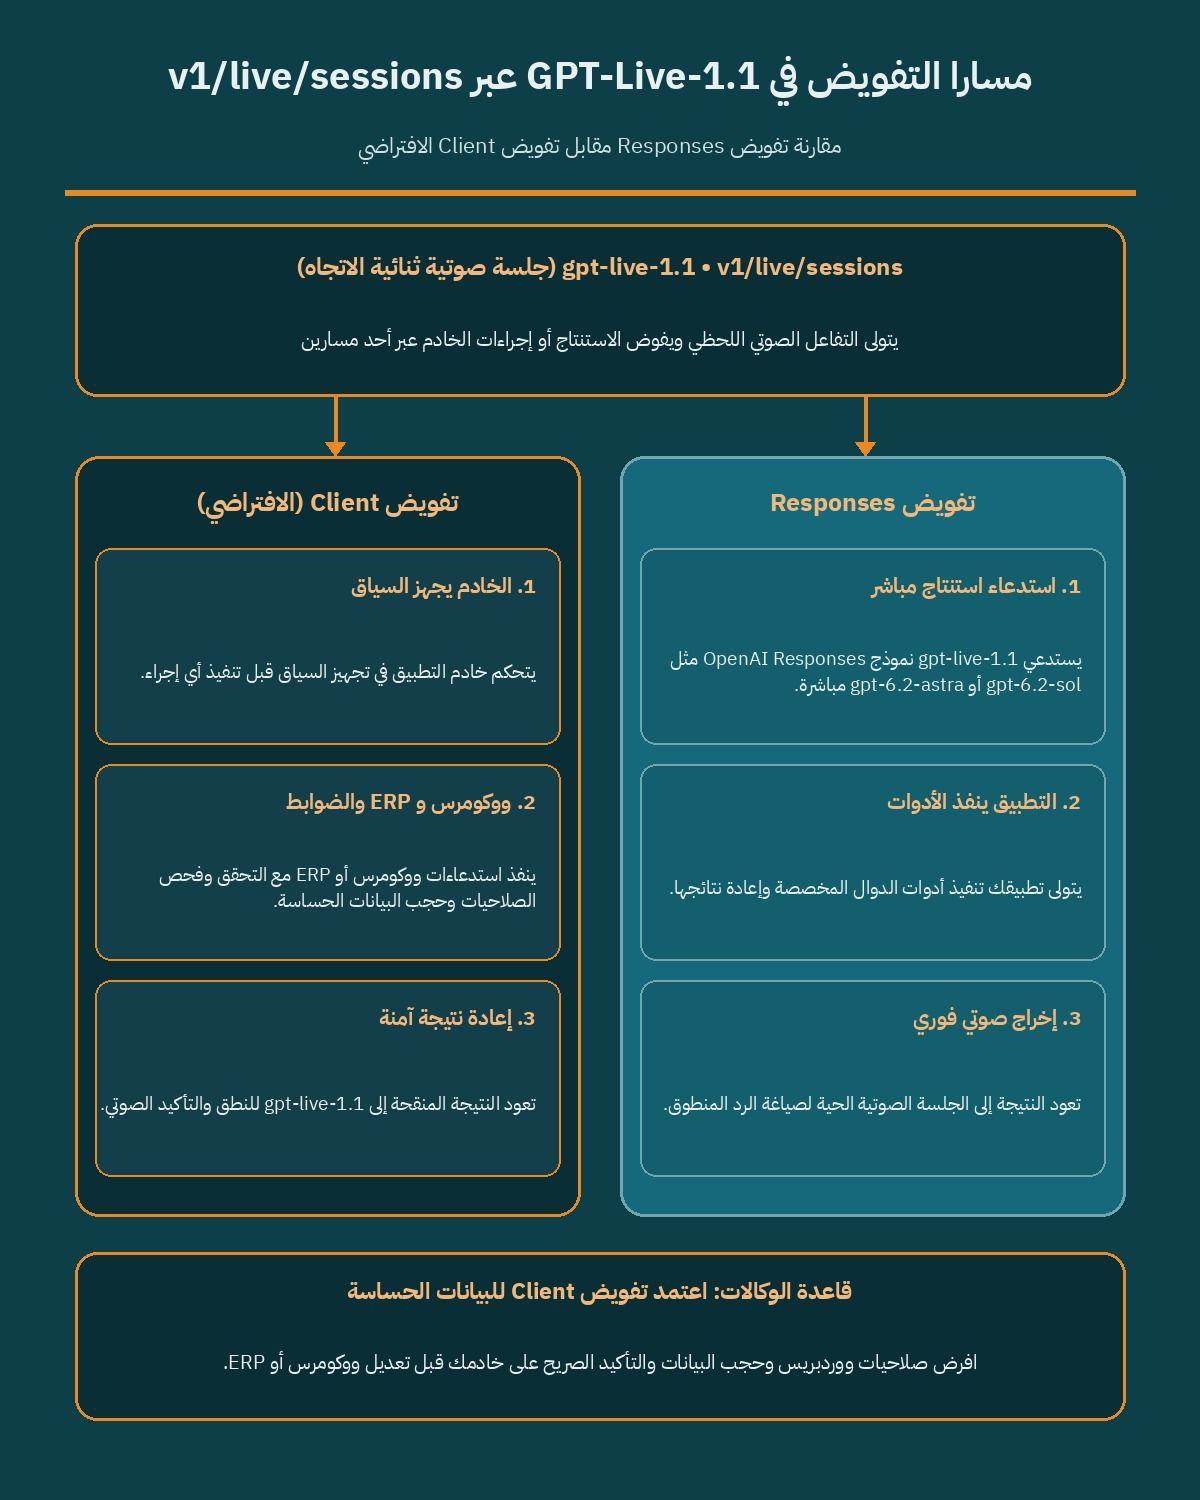
عند تهيئة الجلسة، يختار فريقك آلية هذا التفويض عبر ضبط المعامل delegation.type إما على القيمة "responses" وإما على القيمة الافتراضية "client".
فهم الحدود الفاصلة بين هذين الوضعين ضروري قبل ربط أي مساعد صوتي ببيانات العملاء أو مخزون المتجر.
كيف يعمل تفويض Responses ومتى تختاره
عندما تضبط delegation.type: "responses" في بداية الجلسة، يتولى نظام GPT-Live إدارة طلب الخلفية مباشرة مع أحد نماذج OpenAI Responses، ثم يعيد المخرجات الناتجة إلى مجرى المحادثة الصوتية. وفي أثناء هذه الحلقة، يظل تطبيقك مسؤولا عن تنفيذ أي أدوات دوال مخصصة (Custom Function Tools) يطلبها نموذج الاستنتاج.
بالنسبة للفرق التقنية التي تعتمد بالفعل على أحدث نماذج الاستنتاج من OpenAI، كما شرحنا بالتفصيل في مراجعتنا التقنية لإصداري GPT-6.2 Astra و GPT-6.2 Sol، يتيح وضع Responses لنموذج gpt-live-1.1 تمرير عمليات التحليل متعددة الخطوات أو تشخيص المشكلات المعقدة إلى gpt-6.2-sol أو gpt-6.2-astra مباشرة دون الحاجة إلى كتابة طبقة وسيطة مخصصة لإدارة الاتصال بين النموذجين.
كيف يعمل تفويض العميل Client (الوضع الافتراضي)
عندما تترك المعامل delegation.type على قيمته الافتراضية "client"، يرسل نظام GPT-Live طلب تفويض إلى تطبيقك كلما انطبق أحد شروط Delegate to the backend when أثناء المكالمة. هنا يتسلم خادمك الخلفي زمام التحكم الكامل في دورة حياة المهمة عبر ثلاث خطوات:
- يجهز تطبيقك السياق المطلوب للمهمة بدقة وينقيه من أي بيانات غير لازمة.
- يستدعي خادمك الخدمة الأنسب لتنفيذ الطلب، سواء كانت نموذجا من OpenAI، أو نظام استرجاع معرفي داخلي RAG، أو مسار عمل متعدد الخطوات، أو واجهة حجز مواعيد عيادة، أو مسار WooCommerce REST API.
- يتحقق تطبيقك من المخرجات الخام وينقحها ويحجب البيانات الحساسة (مثل هوامش الربح الداخلية، أو ملاحظات الموظفين، أو البيانات الشخصية غير المصرح بها) قبل إرسال النتيجة المعتمدة إلى
gpt-live-1.1لينطقها للعميل.
وسواء اختار فريقك وضع responses أو وضع client، تشدد وثائق التفويض الرسمية من OpenAI على قاعدة أمنية حاسمة: يظل تطبيقك أنت، وليس النموذج الصوتي، المسؤول الأول والأخير عن فحص الصلاحيات، والتحقق من تأكيدات المستخدم الإلزامية، وحفظ سجلات الأعمال، وإدارة حالة المهمة. لا تعتمد أبدا على تعليمات النموذج الصوتي وحدها لمنع استرداد مالي غير مصرح به أو تغيير عنوان شحن أو إلغاء حجز.
وضع الانتظار القابل للضبط عبر WebRTC وتفاصيل التسعير الرسمية
المحادثات الصوتية الحية على مواقع التجارة الإلكترونية أو بوابات الخدمات لا تسير بوتيرة كلام متواصل طوال الوقت. العميل الذي يتصفح كتالوج أثاث، أو يقرأ نموذج بيانات طبية، أو يبحث عن ملف فاتورة PDF في لسان متصفح آخر قد يصمت لمدة تتراوح بين 20 و 90 ثانية بين السؤال والآخر. في السابق، كان إبقاء جلسة WebRTC مفتوحة وجاهزة خلال فترات الصمت هذه يعني الاستمرار في دفع تسعيرة المعالجة النشطة كاملة، أو إغلاق الاتصال وإجبار العميل على انتظار إعادة الاتصال من الصفر.
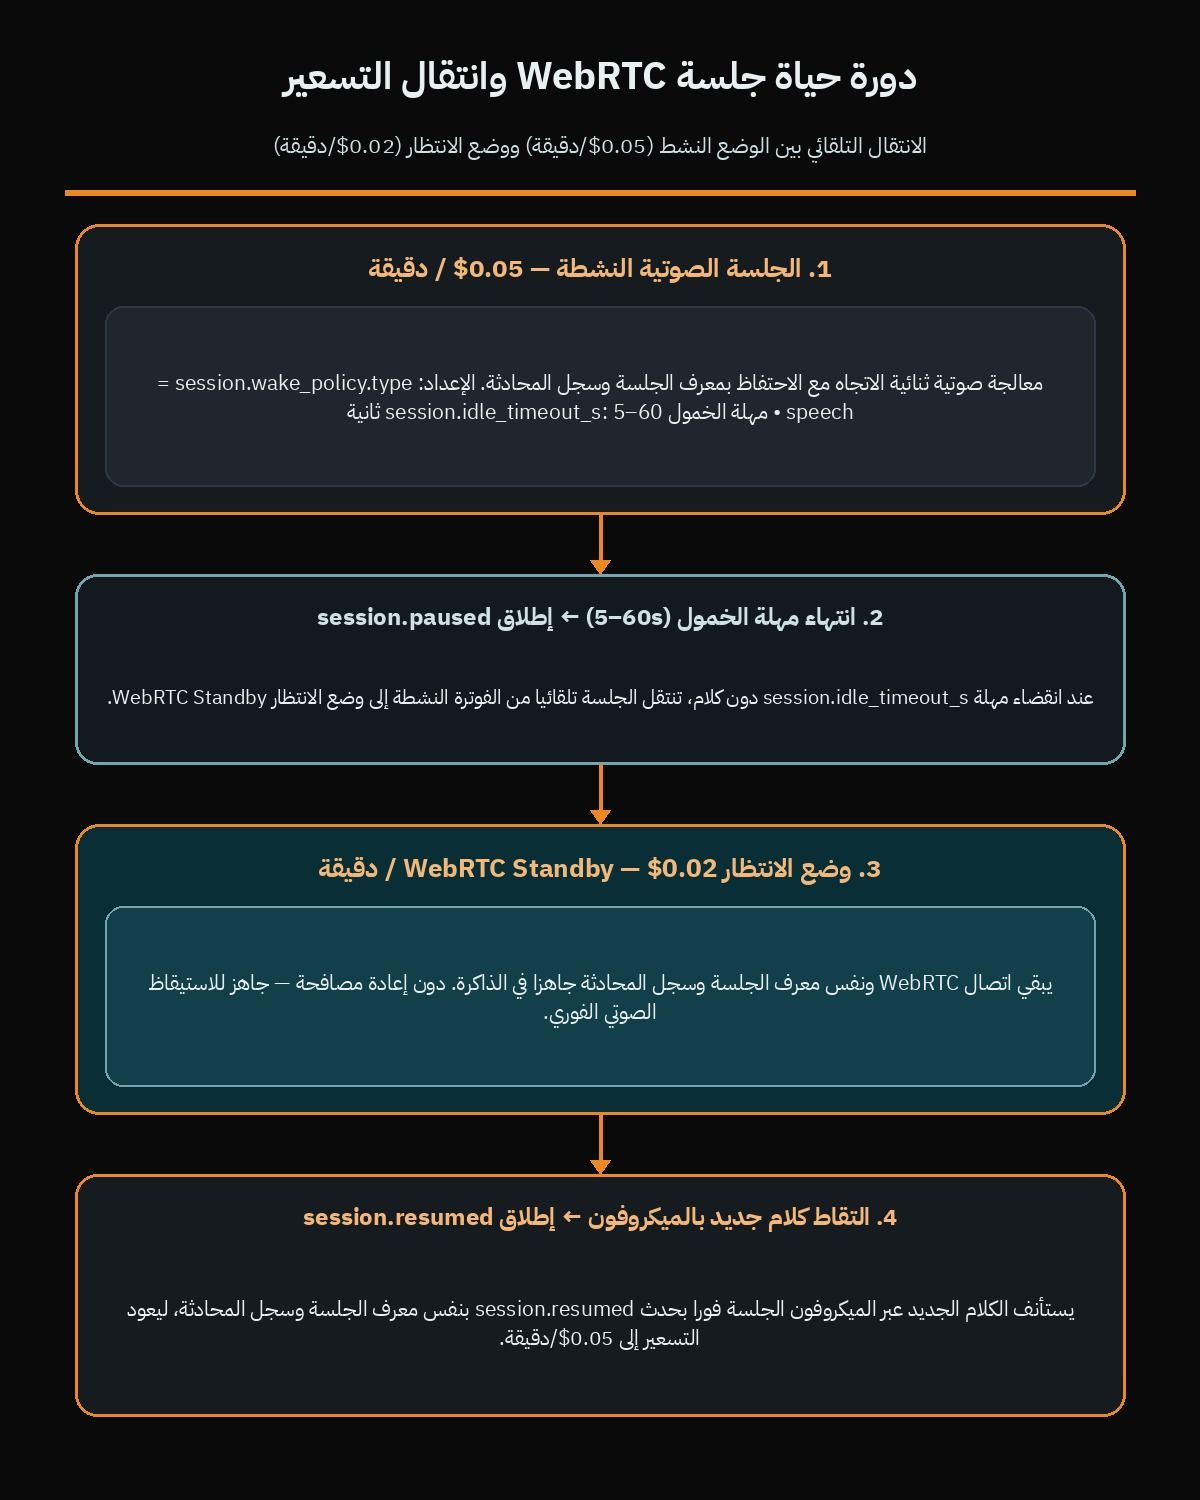
في تحديث 19 نوفمبر 2026، حلت OpenAI هذه المعادلة عبر إطلاق وضع الانتظار القابل للضبط عبر WebRTC (Configurable WebRTC Standby Mode) لكل من gpt-live-1 و gpt-live-1.1. عندما تدخل جلسة WebRTC في وضع الانتظار، تتوقف المعالجة مؤقتا وتنخفض تكلفة مدة الجلسة بنسبة 60 بالمئة وفق الهيكل الرسمي التالي:
- تكلفة مدة الجلسة الحية النشطة (Active):
0.05دولار للدقيقة (أي3.00دولارات للساعة). - تكلفة مدة الجلسة في وضع الانتظار (Standby عبر WebRTC فقط):
0.02دولار للدقيقة (أي1.20دولار للساعة، بانخفاض قدره 60 بالمئة أثناء توقف المعالجة). - فوترة منفصلة لعمليات الخلفية: تحتسب أي استدعاءات لنماذج الخلفية (مثل نماذج Responses المستدعاة أثناء التفويض) واستخدام الأدوات بشكل منفصل وفق أسعارها القياسية المعتمدة.
استيعاب آلية الانتقال بين الحالتين والتفاصيل التشغيلية الدقيقة لوضع الانتظار يحمي ميزانيتك من الفوترة غير المتوقعة ويمنع ضياع الكلمات الأولى عندما يعود العميل للحديث.
ضبط سياسة الاستيقاظ ومهلة الخمول وحساسية التقاط الصوت VAD
يعمل وضع الانتظار حصريا على اتصالات WebRTC، ويتم التحكم فيه عبر ثلاثة معاملات في إعدادات الجلسة:
- المعامل
session.wake_policy.type: اضبط هذا الحقل على القيمة"speech"لكي تنتظر الجلسة اكتشاف كلام بشري قبل بدء المعالجة النشطة أو استئنافها. - المعامل
session.idle_timeout_s: يحدد بعدد صحيح بين5و60ثانية. عندما لا يسجل النظام أي نشاط تفريغ نصي في الإدخال أو الإخراج طوال هذه المهلة، تنتقل الجلسة تلقائيا إلى وضع الانتظار وترسل الحدثsession.paused. - المعامل
session.wake_policy.vad_threshold: يتيح لك اختياريا ضبط حساسية اكتشاف النشاط الصوتي (Voice Activity Detection) بقيمة بين0و1(القيمة الافتراضية0.5) لتلائم مستوى الضوضاء المحيطة المعتاد لدى مستخدميك.
لكي تعمل ميزة الاستيقاظ بالكلام (Wake-on-Speech) بصورة صحيحة، يجب أن يبقي تطبيق الواجهة الأمامية مسار الميكروفون في WebRTC نشطا ومفتوحا أثناء وجود الجلسة في حالة التوقف المؤقت. وبمجرد أن يتحدث العميل بمستوى يتجاوز عتبة VAD المحددة، تستأنف المعالجة تلقائيا، ويرسل الخادم الحدث session.resumed، وتستمر المحادثة على نفس اتصال WebRTC وبنفس معرف الجلسة (Session ID) مع بقاء سجل الحوار كاملا دون أي فقدان.
تفصيلان تقنيان يجب معالجتهما في واجهة المستخدم
تنبه وثائق إدارة المحادثات الحية من OpenAI إلى سلوكين تقنيين يجب على مطوري الواجهات الأمامية مراعاتهما عند بناء أداة اتصال WebRTC:
- كتم الميكروفون وحده لا يفعل وضع الانتظار فورا: إذا ضغط المستخدم على زر كتم الصوت (Mute) في واجهة موقعك، تظل الجلسة في حالة الفوترة النشطة (
0.05دولار للدقيقة) إلى أن تنقضي مهلةsession.idle_timeout_sبالكامل دون تسجيل أي نص إدخال أو إخراج. لذلك إذا كانت واجهتك تتضمن زر “إيقاف مؤقت”، اجمع بين مهلةidle_timeout_sقصيرة (مثل5إلى10ثوان) ومؤشر بصري واضح يستمع إلى الحدثsession.paused. - زمن الاستجابة الأول بعد الاستيقاظ من الانتظار: عندما تستيقظ الجلسة من وضع الانتظار إثر كلمة قصيرة جدا (مثل قول المتصل “ألو؟” أو “معي؟”)، قد يستغرق الرد الأول وقتا أطول قليلا ريثما تعود المعالجة النشطة للعمل. تهيئة واجهة الاستخدام وتعليمات النموذج للتعامل بسلاسة مع عبارات الاستيقاظ القصيرة يمنع اضطرار العميل لتكرار سؤاله مرتين.
وحتى مع انخفاض تكلفة الانتظار إلى 0.02 دولار للدقيقة، يظل من الضروري وضع سقف زمني أقصى على مستوى تطبيقك لإغلاق الجلسات المهجورة. فإذا ترك زائر صفحة المتجر مفتوحة وغادر مكتبه لعشرين دقيقة، لا داعي لدفع 0.02 دولار عن كل دقيقة بلا جدوى؛ برمج واجهتك لإنهاء اتصال WebRTC تماما بعد مرور دقيقتين أو ثلاث دقائق متواصلة في وضع الانتظار، مع إتاحة زر إعادة اتصال بضغطة واحدة يمرر سجل المحادثة المحفوظ عبر الحقل input.
تصميم معمارية GPT-Live-1.1 لمواقع ووردبريس ومتاجر ووكومرس في المنطقة العربية
تعتمد التجارة الإلكترونية وقطاعات الخدمات في مصر والسعودية والإمارات والكويت وقطر بشكل كبير على التواصل المباشر قبل الشراء. يفضل كثير من المتسوقين وعملاء الشركات الاستفسار صوتيا للتأكد من توفر المقاس أو تغطية الضمان أو مواعيد التوصيل أو فترات الحجز المتاحة في العيادة قبل إتمام الدفع. إضافة مساعد صوتي ثنائي اللغة يعتمد على gpt-live-1.1 تمنح موقعك قدرة حقيقية على استيعاب العملاء الذين يفضلون التحدث بدلا من الكتابة على شاشة الهاتف، بشرط أن تبنى معمارية الربط مع ووردبريس بطريقة صحيحة.
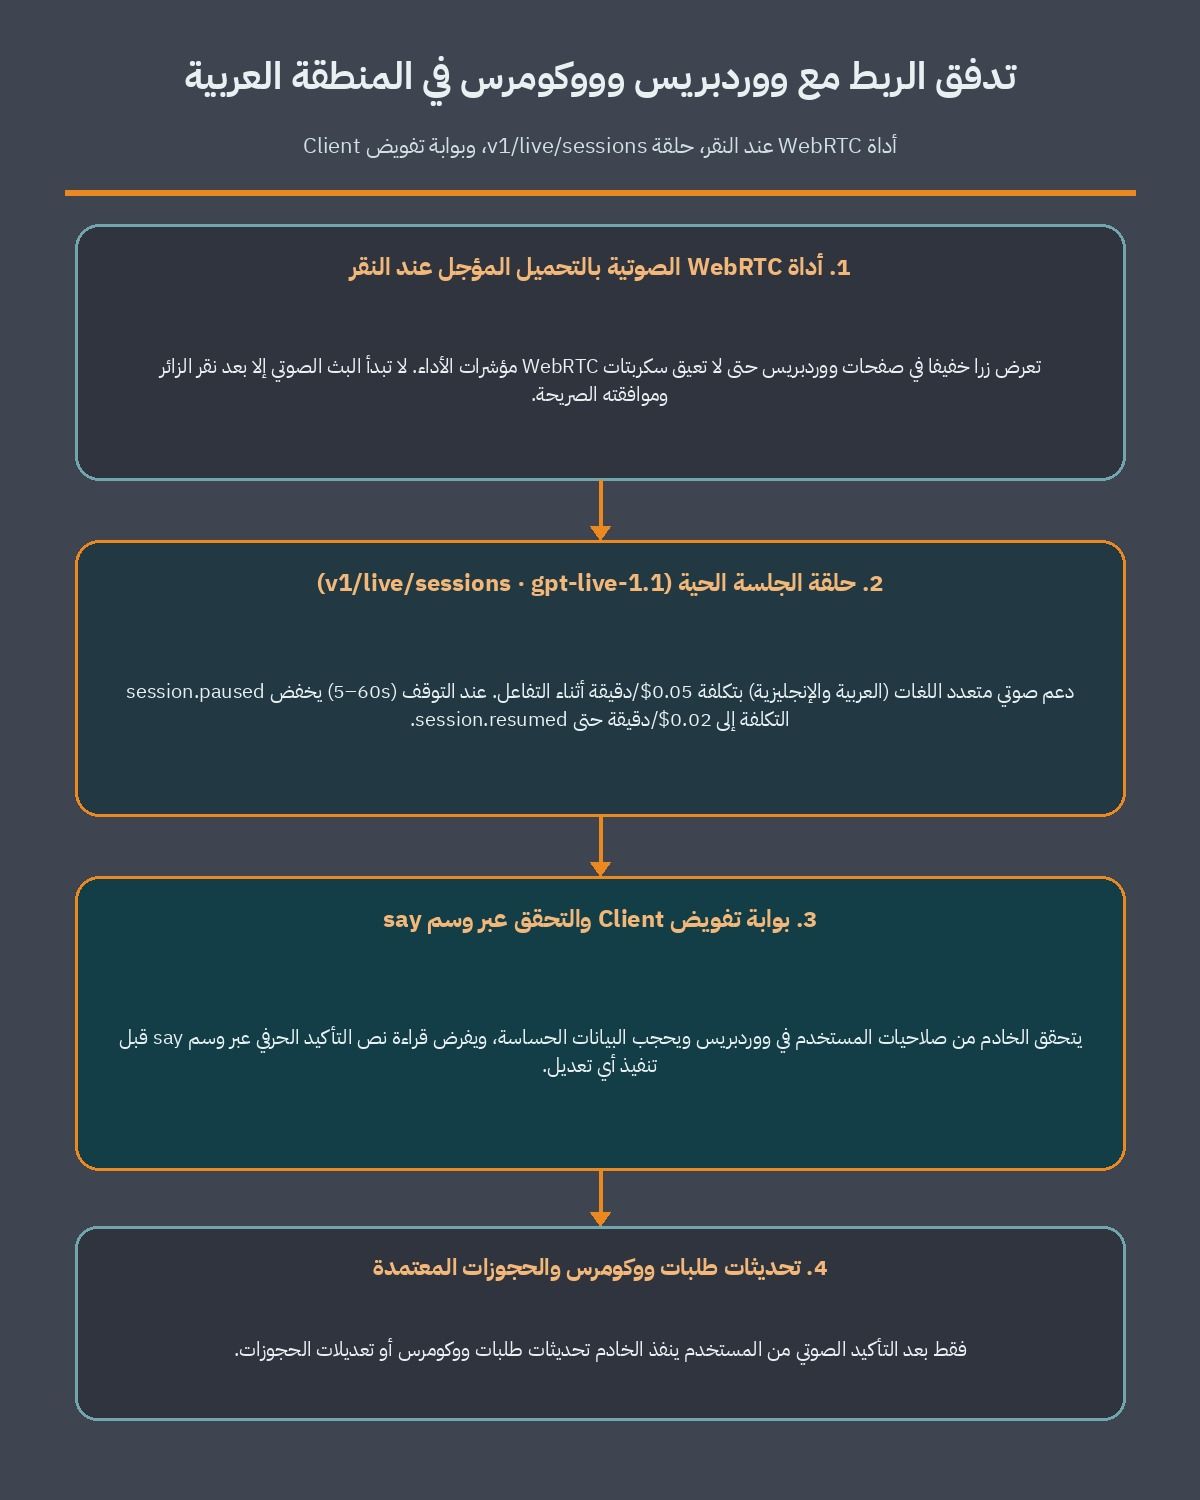
عندما نصمم حلول الذكاء الاصطناعي والواجهات الصوتية ضمن خدمات تطوير مواقع ووردبريس، نفصل المعمارية دائما إلى ثلاث طبقات مستقلة: واجهة WebRTC خفيفة تعمل بالتحميل المؤجل في المتصفح، وخادم وسيط آمن لإصدار الرموز وإدارة التفويض، ووحدات معالجة بيانات محمية تتصل بووردبريس أو ووكومرس.
هذا الفصل الثلاثي يحمي مفاتيح API الخاصة بك من الانكشاف في المتصفح، ويحافظ على سرعة تحميل الصفحات، ويمنع أي تعديل غير مصرح به في قاعدة بيانات الموقع.
إدارة التبديل اللغوي بين العربية والإنجليزية في المكالمات الحية
في المكالمات الواقعية داخل المنطقة العربية، يدمج العميل التراكيب العربية مع المصطلحات التجارية الإنجليزية تلقائيا. قد يبدأ مشتري قطع غيار سيارات في جدة أو عميل متجر أزياء في الإسكندرية حديثه بالعربية، ثم يقرأ كود القطعة SKU بالحروف والأرقام الإنجليزية، ثم يعود للعربية للسؤال عن سياسة الاستبدال، ويملي اسم الشارع أو المجمع السكني بمصطلحات إنجليزية.
مع نموذج gpt-live-1.1، يمكنك تعزيز قدراته المحسنة في النطق متعدد اللغات وثبات الصوت عبر اللغات من خلال ضبط حقل instructions وقسم Delegation policy وفق الأنماط المحلية التالية:
- الرد بلغة المتصل مع الحفاظ على المعرفات الإنجليزية كما هي: وجه النموذج للرد بعربية طبيعية وواضحة عندما يتحدث العميل بالعربية، مع إبقاء أرقام الطرازات وأكواد SKU وأسماء العلامات التجارية بصيغتها الدقيقة الموجودة في كتالوج المتجر.
- تطبيع الأرقام وإعادة قراءتها قبل التفويض: ضمن قواعد
Delegate to the backend when، ألزم النموذج الصوتي بإعادة قراءة رقم الهاتف أو رقم الطلب أو تاريخ الحجز على مسامع العميل وأخذ تأكيد شفهي سريع قبل إرسال طلب كتابة أو تعديل إلى الخلفية. - استخدام
session.thinking.appendلتمرير مصطلحات الصفحة الحالية: بمجرد أن يضغط الزائر على زر التحدث الصوتي داخل صفحة منتج، أرسل اسم المنتج بالعربية والإنجليزية مع كود SKU وسعره الحالي في سياق التفكير الصامت ليتعرف عليه النموذج فورا إذا نطقه العميل بأي من اللغتين.
تأمين صلاحيات ووكومرس وحماية بيانات العملاء عبر تفويض Client
بالنسبة للمتاجر الإلكترونية التي تقرر توظيف مطور ووكومرس لربط المساعد الصوتي ببيانات الطلبات والمخزون الحية، يجب أن يكون delegation.type: "client" هو خيارك الدائم. منح جلسة صوتية صلاحية كتابة مباشرة وغير مفلترة على مسارات المتجر يشكل خطرا كبيرا على أمن البيانات وهوامش الربح.
بدلا من ذلك، يتولى مسار WordPress REST API المخصص أو الخادم الوسيط لديك معالجة كل طلب تفويض وفق ضوابط صارمة من طرف الخادم:
- استعلامات الكتالوج العامة للقراءة فقط: الأسئلة العامة (مثل التحقق من توفر مقاس معين أو مقارنة مواصفات جهازين) تنفذ على بيانات المنتجات المخزنة مؤقتا (Cached) وتعيد ملخصات JSON موجزة إلى
gpt-live-1.1. - تتبع الطلبات المحمي بالمصادقة: قبل الاستعلام عن تفاصيل طلب خاص، يتحقق خادمك من رمز الجلسة (WordPress Nonce) للمستخدم المسجل أو يطابق رقم الطلب مع رمز تحقق OTP مرسل إلى هاتف العميل، ثم يحجب عنوان الفوترة الكامل وبيانات الدفع قبل إعادة حالة الشحنة إلى الجلسة الصوتية.
- تأكيد صريح ومكتوب قبل أي تعديل في الحالة: إذا طلب المتصل تغيير موعد التوصيل أو إلغاء منتج قبل شحنه أو تثبيت حجز خدمة، يسجل تطبيقك حالة المهمة في قاعدة البيانات، ويستخدم
session.instructions.appendمع الصيغةRead the following exactly, without an introduction or explanation: <say>...</say>لقراءة شروط التعديل حرفيا، ولا ينفذ عملية الكتابة إلا بعد توثيق موافقة العميل في الخادم.
حماية سرعة مواقع ووردبريس العربية ومؤشرات Core Web Vitals
من الأخطاء الشائعة عند تركيب إضافات المحادثة الصوتية الجاهزة تحميل مكتبات WebRTC الثقيلة وملفات معالجة الصوت وطلبات تهيئة الجلسة مع كل زيارة لأي صفحة في الموقع. على شبكات الهواتف المحمولة، يؤدي تشغيل سكربتات الوسائط قبل تفاعل الزائر إلى تدهور مؤشر الاستجابة للتفاعل (INP) وتأخير ظهور أكبر عنصر مرئي (LCP).
لتطبيق نفس المنهجية الهندسية التي نعتمدها في دليل تسريع مواقع ووردبريس العربية، صمم زر تشغيل المساعد الصوتي كعنصر HTML و CSS خفيف جدا بدون أي مكتبات خارجية عند التحميل الأولي للصفحة. لا تقم بجلب حزمة WebRTC أو طلب إذن الميكروفون أو فتح اتصال v1/live/sessions إلا بعد أن ينقر الزائر بنفسه على زر “تحدث مع خدمة العملاء”. وفور بدء الاتصال، اضبط session.wake_policy.type: "speech" و session.idle_timeout_s: 15 بحيث تنتقل الجلسة تلقائيا إلى تسعيرة الانتظار 0.02 دولار للدقيقة كلما صمت المتسوق لتصفح صور المنتج أو مراجعة سلة المشتريات.
من يجب أن يستخدم النموذج الآن وكم يكلف فعليا وما خطوات فريقك هذا الأسبوع
لا تحتاج كل قناة تواصل مع العملاء إلى بث صوتي حي مزدوج الاتجاه. قبل تخصيص ساعات تطوير من فريقك أو ميزانية شهرية لواجهة OpenAI، قارن قدرات gpt-live-1.1 بطبيعة رحلة العميل وقيمة الطلب في نشاطك التجاري.
من يجب أن يعتمد GPT-Live-1.1 الآن ومتى يفضل التريث
- اعتمد
gpt-live-1.1الآن إذا: كنت تدير مركز دعم عملاء ثنائي اللغة (عربي وإنجليزي)، أو منصة حجز مواعيد طبية وعقارية، أو خطوط اتصال هاتفية عبر SIP، أو متجر ووكومرس لمنتجات ذات قيمة طلب متوسطة وعالية حيث يقاطع المتصلون الحديث ويخلطون اللغتين في نفس الجملة ويحتاجون إلى ردود صوتية فورية أثناء فحص الأنظمة الخلفية. - انتقل فورا من
gpt-live-1إذا: كانت لديك جلسات عاملة بالفعل على مسارv1/live/sessionsوترغب في تبسيط تعليمات التفويض باللغة الطبيعية، وتحسين نطق الكلمات متعددة اللغات، وتوفير 60 بالمئة من تكلفة دقائق التوقف المؤقت عبر WebRTC. - اكتف بالدردشة النصية أو الرسائل الصوتية غير المتزامنة إذا: كان أغلب تواصل عملائك يعتمد على رسائل نصية متقطعة أو إرسال صور مستندات، أو كنت تبيع منتجات منخفضة الهامش بحيث تتجاوز تكلفة الجلسة الصوتية الحية (بين
0.02و0.05دولار للدقيقة) ميزانية الدعم المسموح بها لكل طلب.
حساب التكلفة الفعلي للجلسات النشطة وفترات الانتظار
عند إعداد ميزانية التشغيل لنموذج gpt-live-1.1، افصل حساب التكلفة إلى شقين: تكلفة مدة الجلسة الحية على مسار v1/live/sessions، وتكلفة المهام المفوضة في الخلفية. تحاسب OpenAI على مدة الجلسة الصوتية بواقع 0.05 دولار للدقيقة (3.00 دولارات للساعة) في الوضع النشط، و 0.02 دولار للدقيقة (1.20 دولار للساعة) في وضع الانتظار عبر WebRTC، بينما تحسب رموز نماذج الخلفية واستدعاءات الأدوات بشكل منفصل.
لنأخذ مثالا عمليا لمكالمة دعم عملاء عبر WebRTC مدتها 5 دقائق على متجر ووكومرس: يتحدث المتسوق ويستمع للمساعد الصوتي لمدة 3 دقائق، ويقضي دقيقتين في صمت أثناء تصفح جدول المقاسات أو قراءة رمز التحقق على هاتفه بينما ينشط وضع الانتظار. بدون وضع الانتظار، تكلف دقائق الجلسة الخمس بالسعر النشط الثابت 0.25 دولار. أما مع تفعيل وضع الانتظار عبر WebRTC خلال دقيقتي الصمت (3 دقائق بسعر 0.05 دولار زائد دقيقتين بسعر 0.02 دولار)، تنخفض تكلفة مدة الجلسة إلى 0.19 دولار للمكالمة الواحدة، يضاف إليها فقط التكلفة البسيطة لرموز أي استعلام خلفي تم تفويضه.
خمس خطوات عملية لتنفيذها مع فريقك هذا الأسبوع
- مراجعة مسار الاتصال وحدود التزامن: تأكد من أن خدمة الصوت لديك تتصل حصريا بالمسار
v1/live/sessionsمع ضبطmodel: "gpt-live-1.1"، وراقب حدود الجلسات المتزامنة المستقلة الخاصة به بشكل منفصل عن أي حركة مرور قديمة علىgpt-live-1. - إعادة هيكلة التعليمات إلى أقسام السياسات الثلاثة: احذف أي رموز
<|SpawnThinking|>قديمة واستبدلها بأقسامBackchannel policyوInterruption policyوDelegation policy(شاملةBackend toolsوDelegate to the backend whenوDo not delegate when) ضمن سقف16,384رمزا. - تفعيل وضع الانتظار عبر WebRTC ومؤقت الفصل النهائي: اضبط
session.wake_policy.type: "speech"واختبر قيما للمعاملsession.idle_timeout_sبين10و20ثانية (ضمن النطاق المسموح من5إلى60ثانية)، مع إضافة مؤقت في تطبيقك يغلق الجلسات المتروكة في وضع الانتظار بعد دقيقتين إلى ثلاث دقائق. - تأمين صلاحيات تفويض Client في ووردبريس وووكومرس: التزم بالوضع الافتراضي
delegation.type: "client"عند الربط بمتجرك، وطبق التحقق من الهوية وحجب البيانات الحساسة في الخادم، واستخدمsession.instructions.appendمع وسم<say>...</say>لقراءة نصوص التأكيد حرفيا قبل أي عملية كتابة في قاعدة البيانات. - اختبار جودة الصوت ثنائي اللغة وسرعة الصفحة: جرب سيناريوهات حوار تجمع العربية والإنجليزية على أكثر 20 سؤالا شيوعا لدى عملائك باستخدام الأصوات المدمجة (بدءا من الصوت الافتراضي
marin)، وتأكد من أن سكربت WebRTC لا يتحمل إلا بعد نقر المستخدم على زر الاتصال.
إذا كنت تخطط لإضافة مساعد صوتي حي أو ربط خطوط SIP الهاتفية بمتجر ووكومرس أو منصة حجز على ووردبريس وتريد مراجعة هندسية تضمن الأمان وضبط التكلفة منذ اليوم الأول، يمكنك حجز استشارة مجانية لنرسم معا المعمارية الأنسب لمشروعك.
الأسئلة الشائعة
ما هو مسار البرمجة الذي يدعم نموذج gpt-live-1.1 في OpenAI وهل يعمل مع مسارات المحادثة النصية أو Realtime القديمة؟
يعمل نموذج gpt-live-1.1 حصريا عبر مسار v1/live/sessions فقط، ولا تدعمه شركة OpenAI على مسارات v1/chat/completions أو v1/responses أو v1/realtime أو مسارات الصوت التقليدية مثل v1/audio/speech و v1/audio/transcriptions. يقبل النموذج المدخلات الصوتية والنصية ويخرج ردودا صوتية ونصية مع دعم البث المباشر واستدعاء الدوال عبر بروتوكولات WebRTC و WebSockets ومكالمات SIP الهاتفية. كما يمتلك النموذج حدودا مستقلة لعدد الجلسات المتزامنة عبر مناطق المعالجة منفصلة تماما عن حصص نموذج gpt-live-1 السابق.
كيف يعمل تسعير وضع الانتظار WebRTC في نموذج gpt-live-1.1 وكيف يمكن تفعيله في الجلسة؟
تبلغ تكلفة الجلسة النشطة 0.05 دولار للدقيقة أو 3.00 دولارات للساعة، ويخفض وضع الانتظار عبر WebRTC التكلفة بنسبة 60 بالمئة لتصبح 0.02 دولار للدقيقة أو 1.20 دولار للساعة أثناء توقف المعالجة. لتفعيل هذا الوضع، اضبط session.wake_policy.type على القيمة speech وحدد مهلة الخمول session.idle_timeout_s برقم صحيح بين 5 و 60 ثانية. يلزم إبقاء مسار الميكروفون نشطا ليستأنف النموذج المحادثة تلقائيا بنفس معرف الجلسة وسجل الحوار فور تحدث العميل.
متى يجب على موقع ووردبريس أو متجر ووكومرس استخدام تفويض العميل Client بدلا من تفويض Responses؟
اختر تفويض العميل client، وهو الوضع الافتراضي عند بدء الجلسة، كلما احتاج المساعد الصوتي إلى الاستعلام عن طلبات ووكومرس أو التحقق من صلاحيات المستخدمين أو حجب البيانات الحساسة أو تنسيق عمليات أنظمة المخزون وإدارة العملاء. اختر تفويض responses عندما تريد من النموذج الصوتي استدعاء نموذج استنتاج مباشرة مثل gpt-6.2-sol أو gpt-6.2-astra بينما ينفذ تطبيقك أدوات الدوال المخصصة. وفي الحالتين يظل تطبيقك مسؤولا عن فحص الصلاحيات وتأكيدات المستخدم وحفظ سجلات العمل.
ما الفرق بين صياغة تعليمات التفويض باللغة الطبيعية في gpt-live-1.1 والطريقة السابقة في gpt-live-1؟
في إصدار gpt-live-1 السابق، كان المطورون يعتمدون على رمز SpawnThinking الخاص داخل التعليمات لتشغيل التفكير في الخلفية وتمرير الأدوات. أما مع gpt-live-1.1، فتكتب قواعد مباشرة باللغة الطبيعية تحت قسم Delegation policy توضح أدوات الخلفية Backend tools وحالات التفويض Delegate to the backend when وحالات عدم التفويض Do not delegate when. يدمج هذا القسم مع سياسة الاستماع Backchannel policy وسياسة المقاطعة Interruption policy ضمن حد التعليمات البالغ 16,384 رمزا.
كيف يساعد نموذج gpt-live-1.1 في تحسين خدمة العملاء بالعربية والإنجليزية على مواقع ووردبريس في المنطقة العربية؟
يمزج المتصلون في مصر والخليج عادة بين الحديث بالعربية وذكر العلامات التجارية وأكواد المنتجات SKU وعناوين الشحن ومصطلحات الحجز بالإنجليزية في الجملة نفسها. وبفضل تحسين دقة تفريغ الكلام والنطق متعدد اللغات وثبات نبرة الصوت عبر اللغات في gpt-live-1.1، تلتقط الجلسة الصوتية الطلبات المزدوجة بدقة أعلى دون تغير في هوية المتحدث. وفي الوقت نفسه، يحافظ التحميل المؤجل لأداة WebRTC بعد نقر الزائر على سرعة موقع ووردبريس ومؤشرات Core Web Vitals.
المراجع
- OpenAI API Documentation Changelog (November 19, 2026 and November 2, 2026 Releases)
- OpenAI API Model Reference: gpt-live-1.1 Capabilities, Endpoints, and Pricing
- OpenAI Developer Guide: Live API Overview and Transport Options (WebRTC, WebSockets, SIP)
- OpenAI Developer Guide: Managing Live Conversations and Configurable WebRTC Standby Mode
- OpenAI Developer Guide: Live Prompting Policies, Plain-Language Delegation, and Runtime Appends
- OpenAI Developer Guide: Live Delegation Architecture (Responses Delegation vs. Client Delegation)