---
id: 13277
title: "نموذج Reflection Beam: نموذج برمجة مفتوح الأوزان بحجم 501 مليار معامل على AWS"
slug: "reflection-beam-open-coding-model"
lang: "ar"
url: "https://heshamsaad.com/ar/reflection-beam-open-coding-model/"
markdown_url: "https://heshamsaad.com/en/reflection-beam-open-coding-model.md"
translations: {"en":"https://heshamsaad.com/en/reflection-beam-open-coding-model/"}
description: "نموذج Reflection Beam نموذج برمجة مفتوح المصدر بترخيص Apache 2.0 وحجم 501 مليار معامل: نتائجه ومقارنته بالمنافسين وتكلفة تشغيله على سيرفر خاص في AWS."
author: "Omar Khaled"
date_published: "2026-10-17T08:37:01Z"
date_modified: "2026-10-22T17:14:54Z"
categories: ["AI News"]
tags: ["AWS","Reflection AI","Reflection Beam","أخبار الذكاء الاصطناعي","تشغيل نموذج ذكاء اصطناعي على سيرفر خاص","نموذج برمجة مفتوح المصدر"]
featured_image: "https://heshamsaad.com/wp-content/uploads/2026/10/reflection-beam-open-coding-model-og-v2-ar.jpg"
word_count: 2105
reading_time_min: 11
content_sha256: "941340318fc67f8e4b8acf6990af64679ad26ee227f8c5fa2be1e1410134e55e"
---
# نموذج Reflection Beam: نموذج برمجة مفتوح الأوزان بحجم 501 مليار معامل على AWS
نموذج Reflection Beam هو أول نموذج مفتوح الأوزان تطرحه شركة Reflection AI الأمريكية، وصار بالإمكان منذ 16 أكتوبر 2026 تشغيله من خدمة Amazon SageMaker JumpStart في منطقتين من مناطق AWS. صمم النموذج لأعمال الوكلاء البرمجيين: إصلاح مشكلات GitHub، وتنفيذ أوامر الطرفية، واستدعاء الأدوات، وإنجاز مهام من عدة خطوات. أوزانه منشورة على Hugging Face بترخيص Apache 2.0، فيمكنك تشغيله على بنيتك الخاصة وتعديله واستخدامه تجاريا. لكن هناك عقبة واضحة: حجمه 501 مليار معامل، وتشغيله يحتاج خادما كاملا من أقوى بطاقات NVIDIA.
نستعرض هنا ما أطلقته Reflection وAWS فعلا، وكيف يقف النموذج أمام نماذج البرمجة المفتوحة الأخرى، وكم يكلف تشغيله على AWS بحساب مأخوذ من قائمة أسعار AWS نفسها، ولمن يناسب ولمن لا يناسب. المعلومات مصدرها إعلان Reflection، وبطاقات النموذج على Hugging Face، ومدونة AWS للتعلم الآلي، وصفحة What's New، وبيانات أسعار AWS. أما نتائج الاختبارات فهي كما أعلنتها Reflection، ولم يتحقق منها طرف مستقل بعد.
## ما الذي صدر ومتى؟
التاريخ هنا مهم، لأن رابط إعلان AWS يحتوي على «2026/01» وكأنه صدر في يناير. لكن الصفحة نفسها تقول «Posted on: Oct 16, 2026»، وبياناتها الوصفية تؤكد التاريخ ذاته. إذن هو إصدار جديد فعلا.
- 5 أكتوبر 2026: نشرت Reflection مقال «Introducing Beam» بوصفه معاينة، مع وصول مبكر عبر قائمة انتظار ووعد بنشر الأوزان خلال الشهر.
- من 7 إلى 10 أكتوبر 2026: ظهر مستودع BF16 على Hugging Face في 7 أكتوبر، ثم مستودعا FP8 وNVFP4 في 10 أكتوبر بحسب بيانات المنصة.
- 16 أكتوبر 2026: أعلنت AWS توفر النموذج في SageMaker JumpStart ونشرت دليل التشغيل على مدونتها. وتذكر صفحة What's New أيضا أن النموذج نقل وحسن للعمل على شرائح AWS Trainium3.
## نموذج Reflection Beam في سطور
بحسب بطاقة النموذج على Hugging Face:
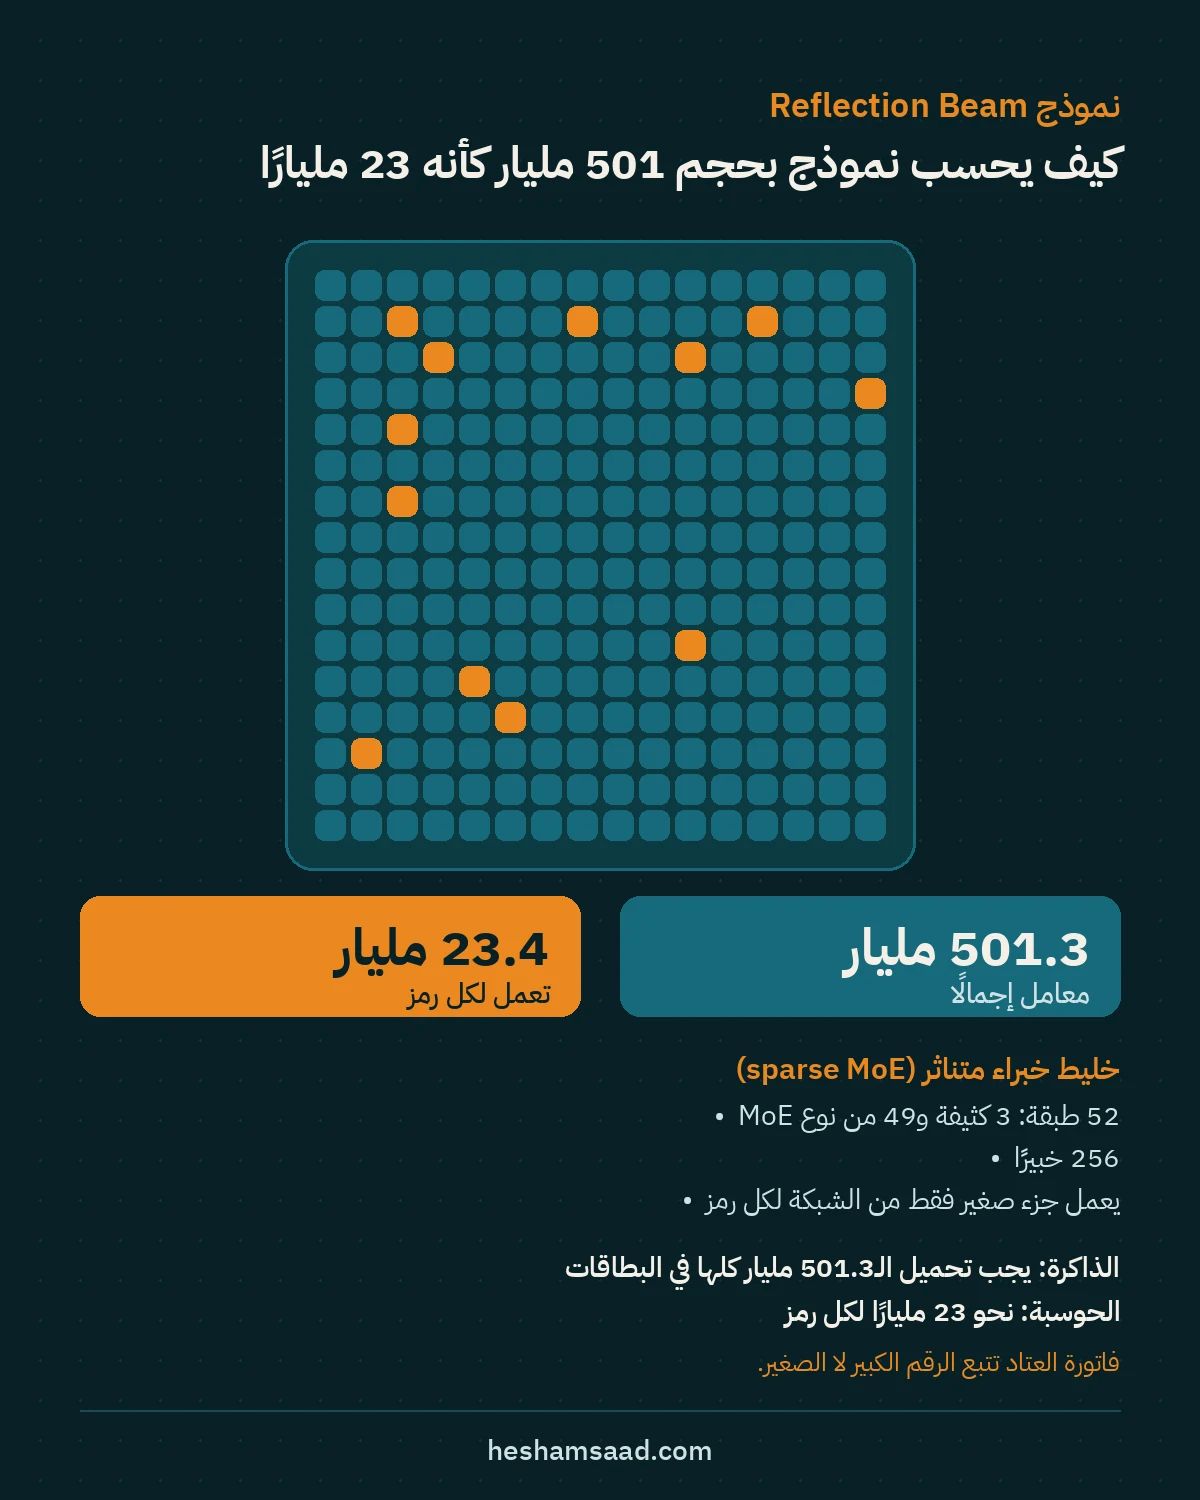
- البنية: خليط خبراء متناثر (sparse MoE)، فيه 501.3 مليار معامل إجمالا، ويعمل منها 23.4 مليار فقط لكل رمز، موزعة على 52 طبقة (3 كثيفة و49 من نوع MoE) و256 خبيرا.
- الانتباه: انتباه جماعي بوابي (gated GQA) مع نافذة منزلقة.
- نافذة السياق: مليون رمز. وتصفها AWS بأنها طول سياق فعلي قدره مليون رمز «بحسب ما أعلنته Reflection».
- المدخلات والمخرجات: نص فقط، وطور «للإنجليزية في الأساس».
- حد المعرفة: 30 يونيو 2026.
- صيغ الأوزان: BF16 وFP8 وNVFP4، لكل منها مستودع مستقل. صيغة FP8 أعدت بأداة llm-compressor من فريق vLLM، وNVFP4 بأداة NVIDIA Model Optimizer.
- الترخيص: Apache 2.0. وتنص البطاقة على أن Reflection لا تمنع التقطير ولا تدريب نماذج أخرى على المخرجات ولا الضبط الدقيق ولا التكميم ولا الدمج.
- التحكم في التفكير: تذكر مدونة Reflection إعدادا لجهد التفكير؛ القيم المنخفضة تعطي ردودا أقصر، والمرتفعة تسمح بتفكير أطول للمهام الصعبة.
فكرة خليط الخبراء أن النموذج لا يشغل إلا جزءا صغيرا من شبكته لكل رمز، ولهذا يحسب كما لو كان نموذجا بحجم 23 مليارا. لكنك مضطر رغم ذلك إلى تحميل المعاملات كلها في ذاكرة البطاقات، فتتبع فاتورة العتاد الرقم الكبير لا الصغير.
## كيف يؤدي النموذج في الاختبارات؟
هذه نتائج نسخة BF16 كما في بطاقة النموذج، ونسختا FP8 وNVFP4 قريبتان منها بفارق لا يتجاوز نقطتين تقريبا في أغلب الاختبارات.
| الاختبار | BF16 | FP8 | NVFP4 |
|---|---|---|---|
| SWE-bench Verified | 81.6% | 80.2% | 80.7% |
| SWE-bench Multilingual | 78.3% | 78.1% | 77.5% |
| SWE Bench Pro v1 | 66.1% | 65.9% | 65.6% |
| Terminal Bench v2.1 | 80.1% | 78.9% | 78.4% |
| LiveCodeBench | 88.3% | 88.1% | 87.4% |
| MCP Atlas | 80.8% | 81.5% | 80.5% |
| GPQA Diamond | 90.6% | 90.3% | 89.3% |
وتقول Reflection إن النموذج يصل إلى جودة حلول مماثلة لأفضل النماذج المفتوحة بعدد رموز تفكير أقل بنحو ثلاث مرات، وإنه في الاستدلال المتقدم يضاهي GLM 5.2 مع حوسبة أقل بثلاث إلى أربع مرات. وقلة الرموز في كل إجابة تعني تكلفة أقل وردا أسرع، وهذا يهم الوكلاء الذين يكررون الدورات كثيرا أكثر مما تهم نقطة إضافية في اختبار.
ملاحظة صغيرة: أرقام مقال Reflection المنشور في 5 أكتوبر تختلف قليلا عن البطاقة النهائية، فالمقال يذكر 80.9% في SWE-bench Verified والبطاقة 81.6%. اعتمد البطاقة مرجعا حاليا.
## مقارنة مع نماذج البرمجة المفتوحة الأخرى
وضعت Reflection نموذجها بجوار عدة نماذج مفتوحة في جدولها الخاص. هذه أرقام Terminal Bench v2.1 وSWE Bench Pro v1 من ذلك الجدول، و«NR» تعني لم يعلن.
| النموذج | Terminal Bench v2.1 | SWE Bench Pro v1 |
|---|---|---|
| Reflection Beam | 80.1 | 65.5 |
| GLM 5.2 | 81.0 | 62.1 |
| GLM 5.3 | 88.2 | NR |
| Kimi K3 | 88.3 | NR |
| Qwen 3.8 Max | 86.6 | 67.7 |
| DeepSeek V4.1 Flash | 90.6 | NR |
| Nemotron 3 Ultra | 56.4 | 46.4 |
والشركة صريحة في ترتيبها: تصف نموذجها بأنه «منافس للنماذج المفتوحة الأكبر مثل GLM 5.2 ويقترب من Qwen 3.8-Max»، وتعترف بأن نماذج مثل Kimi K3 «ما زالت متقدمة في القدرة الخام». فرهانها على الكفاءة لا على المركز الأول.
ومن بطاقات المنافسين أنفسهم على Hugging Face نستطيع وضع الحجم والترخيص في سياقهما:
- Kimi K3 من Moonshot AI: 2.8 تريليون معامل إجمالا و104 مليارات نشطة، يقبل النص والصورة والفيديو، وسياقه مليون رمز، بترخيص خاص اسمه Kimi K3 License.
- DeepSeek V4.1 Flash: نموذج MoE متعدد الوسائط بعمود فقري من 552 مليار معامل، وسياق حتى مليون رمز، بترخيص MIT.
- GLM 5.3 من Z.ai: منشور بترخيص GLM خاص لا بترخيص مفتوح معياري.
- Qwen3-Coder-Next: 80 مليار معامل إجمالا و3 مليارات نشطة، وسياق أصلي 262,144 رمزا، بترخيص Apache 2.0. أصغر بكثير وأرخص في التشغيل.
- Devstral 2 من Mistral (123 مليارا): سياق 256 ألف رمز، بترخيص MIT معدل.
يقع Beam إذن في منطقة لافتة: ترخيص Apache 2.0 مثل Qwen3-Coder-Next، وسياق مليون رمز مثل Kimi K3 و[DeepSeek V4.1 Flash](https://heshamsaad.com/ar/deepseek-v4-1-flash-harness/)، وحجم بينهما. فإن كنت تبحث عن نموذج برمجة مفتوح المصدر قوي بترخيص مريح، فهو من الخيارات القليلة في فئته. وقد راجعنا إصدارا أمريكيا مفتوحا آخر في مقالنا عن [نموذج Muse Spark Open من ميتا](https://heshamsaad.com/ar/meta-muse-spark-open/)، ويستحق القراءة إلى جانب هذا المقال.
وللمقارنة بخيار مغلق: تعرض قائمة أسعار OpenAI الرسمية نموذج `gpt-6.1-sol` بسعر دولارين لكل مليون رمز مدخلات و10 دولارات لكل مليون رمز مخرجات. مع الواجهة المغلقة تدفع لكل رمز ولا شيء وقت الخمول، ومع التشغيل الذاتي تدفع ثمن الخوادم بالساعة سواء عملت أم لا.
## تشغيل النموذج على AWS: المسارات ومتطلبات البطاقات
يشرح دليل AWS ثلاث طرق لتقديم النموذج:
1. نقطة نهاية لحظية من SageMaker JumpStart: المسار المدار، بحاوية من AWS ونقطة HTTPS جاهزة. متاح عند الإطلاق في US East (N. Virginia) وUS East (Ohio).
2. JumpStart على SageMaker HyperPod Inference: الحاوية المدارة نفسها لكن على عنقود Kubernetes (Amazon EKS) تتحكم فيه.
3. SGLang أو vLLM على HyperPod: حين تحتاج بيئة تشغيل خاصة أو تكميما أو توزيعا مخصصا.
وفي العتاد كانت AWS محددة:
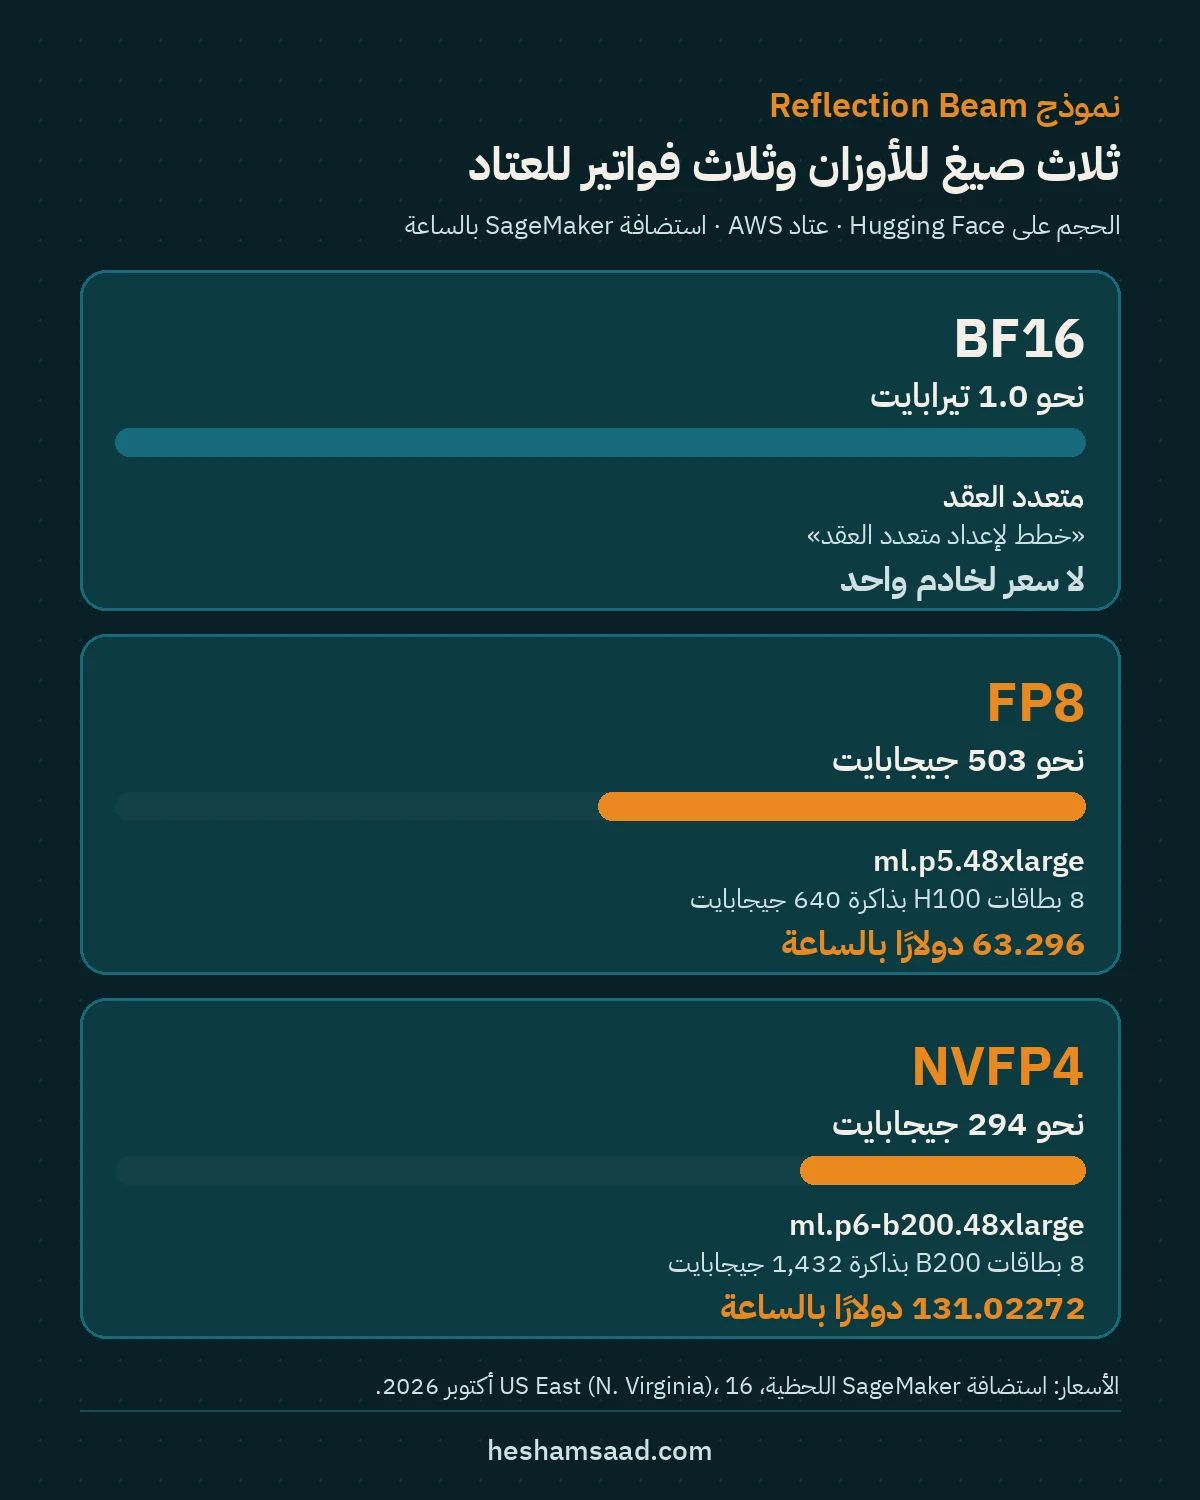
- FP8: خادم ml.p5.48xlarge (8 بطاقات H100 بذاكرة 640 جيجابايت) أو ml.p5e.48xlarge وml.p5en.48xlarge (8 بطاقات H200 بذاكرة 1,128 جيجابايت).
- NVFP4: خادم ml.p6-b200.48xlarge (8 بطاقات B200 بذاكرة 1,432 جيجابايت).
- BF16: «خطط لإعداد متعدد العقد»، لأنها الأكبر في متطلبات الذاكرة.
وأحجام التخزين على Hugging Face توضح السبب: مستودع BF16 نحو 1.0 تيرابايت، وFP8 نحو 503 جيجابايت، وNVFP4 نحو 294 جيجابايت. صيغة FP8 على خادم H100 واحد تترك قرابة 137 جيجابايت فقط لذاكرة KV والتشغيل، وهذا يحد من السياقات الطويلة وعدد الطلبات المتزامنة. وتوصي AWS بحساب الذاكرة للأوزان وKV والتشغيل ثم التأكد باختبار حمل.
## كم يكلف تشغيل نموذج ذكاء اصطناعي على سيرفر خاص؟ الحساب بالتفصيل
الأرقام التالية مأخوذة مباشرة من قائمة أسعار AWS العامة للاستضافة اللحظية في SageMaker ولخوادم EC2 حسب الطلب بنظام Linux في US East (N. Virginia)، كما راجعناها في 16 أكتوبر 2026. ولا تشمل التخزين ونقل البيانات والضرائب والخصومات مثل Savings Plans.
| الخادم (8 بطاقات) | استضافة SageMaker بالساعة | EC2 حسب الطلب بالساعة |
|---|---|---|
| p5.48xlarge (H100) | 63.296 دولارا | 55.04 دولارا |
| p5en.48xlarge (H200) | 72.795 دولارا | 63.296 دولارا |
| p6-b200.48xlarge (B200) | 131.02272 دولارا | 113.9328 دولارا |
تشغيل خادم واحد طوال الشهر (730 ساعة):
- FP8 على ml.p5.48xlarge: 63.296 × 730 = 46,206.08 دولارا شهريا
- FP8 على ml.p5en.48xlarge: 72.795 × 730 = 53,140.35 دولارا شهريا
- NVFP4 على ml.p6-b200.48xlarge: 131.02272 × 730 = 95,646.59 دولارا شهريا
التشغيل في ساعات العمل فقط (8 ساعات × 22 يوم عمل = 176 ساعة):
- ml.p5.48xlarge: 63.296 × 176 = 11,140.10 دولارا شهريا
- ml.p6-b200.48xlarge: 131.02272 × 176 = 23,060.00 دولارا شهريا
ولتقريب الصورة: بسعر gpt-6.1-sol المعلن، يشتري مبلغ 46,206 دولارا نحو 4.6 مليار رمز مخرجات (46,206 ÷ 10 دولارات لكل مليون). فالتشغيل الذاتي لا يربح من حيث التكلفة إلا إذا ظلت البطاقات مشغولة معظم الوقت، أو إذا كنت ملزما بإبقاء الكود والبيانات داخل حسابك.
وهناك فجوتان في بيانات الأسعار: لم نجد سعرا حسب الطلب لخادم p5e.48xlarge في أي من المنطقتين، لا في SageMaker ولا في EC2، ولم نجد سعر استضافة لخادم ml.p6-b200.48xlarge في US East (Ohio). كما تذكر AWS شرائح Trainium3 دون أن تنشر حجم خادم أو سعرا خاصا بالنموذج عليها حتى الآن.
## المزايا والعيوب
### ما يحسب له
- ترخيص Apache 2.0 يسمح بالضبط الدقيق والتقطير والاستخدام التجاري.
- نتائج قوية في SWE-bench Verified وTerminal Bench وMCP Atlas، مع توفير معلن في رموز التفكير.
- سياق مليون رمز يناسب المستودعات الكبيرة.
- تشغيل مدار على AWS من اليوم الأول، مع مسارات SGLang وvLLM.
- الكود لا يغادر حسابك على AWS.
### ما يؤخذ عليه
- تشغيله مكلف: نحو 46 ألف دولار شهريا على الأقل لنقطة نهاية واحدة تعمل باستمرار.
- نص فقط، وتركيزه على الإنجليزية.
- ليس الأعلى نتيجة؛ Kimi K3 وGLM 5.3 وDeepSeek V4.1 Flash تتقدمه في Terminal Bench حتى في جدول Reflection نفسها.
- منطقتان فقط من مناطق AWS عند الإطلاق.
- التقرير التقني «قادم»، فالتحقق المستقل محدود حتى الآن.
## لمن يناسب ولمن لا يناسب؟
يناسب: فرق الهندسة التي تعمل على AWS أصلا وتحتاج إبقاء الكود المصدري داخل حسابها، والشركات التي تشغل وكلاء برمجيين على مدار الساعة فتظل البطاقات مشغولة، والفرق التي تريد ضبط نموذج مفتوح على قاعدة كودها بترخيص مريح.
لا يناسب: المستقلين والوكالات الصغيرة وأغلب الشركات الصغيرة. إن كنت تبني بضعة مواقع أو تصونها، فمساعد برمجة مستضاف أو واجهة تدفع فيها لكل رمز أرخص بكثير. وإن أردت تجربة تشغيل نموذج بنفسك، فنموذج أصغر مثل Qwen3-Coder-Next بداية أعقل.
## ماذا يعني هذا لمواقع ووردبريس والأنشطة التجارية؟
بالنسبة لصاحب موقع ووردبريس عادي، هذا النموذج ليس شيئا تثبته، بل بنية تحتية لفرق التطوير. وأثره عليك غير مباشر: كلما قويت نماذج البرمجة المفتوحة انخفضت تكلفة أدوات البرمجة بالذكاء الاصطناعي، وصار للوكالات التي تلتزم بقواعد صارمة لبيانات عملائها خيار حقيقي للتشغيل الذاتي.
وإن كنت تستكشف الذكاء الاصطناعي لموقعك، فابدأ حيث التكلفة منخفضة. دليلنا عن [بناء موقع ووردبريس بالذكاء الاصطناعي](https://heshamsaad.com/ar/build-wordpress-site-with-ai/) يشرح الأدوات التي تعمل اليوم دون فاتورة بطاقات رسومية. وللإضافات المخصصة أو التكاملات أو سير عمل الوكلاء المرتبطة بموقعك، تساعدك خدمة [تطوير ووردبريس](https://heshamsaad.com/ar/wordpress-development/) في اختيار النموذج والإعداد المناسبين. وإن لم تكن متأكدا هل يستحق التشغيل الذاتي العناء في حالتك، فاحجز [استشارة مجانية](https://heshamsaad.com/ar/free-consultation/) ونفكر في الأمر معا.
## الأسئلة الشائعة
### هل نموذج Reflection Beam مفتوح المصدر فعلا؟
أوزانه منشورة بترخيص Apache 2.0 وهو ترخيص مفتوح مرن، وتسمح البطاقة بالضبط الدقيق والتقطير والاستخدام التجاري. أما بيانات التدريب فغير منشورة.
### هل هو إصدار جديد أم قديم؟
جديد. أعلنته Reflection في 5 أكتوبر 2026، ووصلت الأوزان إلى Hugging Face بين 7 و10 أكتوبر، وإعلان AWS مؤرخ في 16 أكتوبر 2026 رغم وجود «2026/01» في رابطه.
### هل يمكن تشغيله على بطاقة رسومية واحدة؟
لا. تذكر AWS خوادم من 8 بطاقات: H100 أو H200 لصيغة FP8، وB200 لصيغة NVFP4، أما BF16 فتحتاج أكثر من خادم.
### ما مناطق AWS المدعومة؟
عند الإطلاق يتوفر في SageMaker JumpStart بمنطقتي US East (N. Virginia) وUS East (Ohio).
### هل يدعم العربية؟
تقول Reflection إن النموذج طور للإنجليزية في الأساس، ولم تنشر نتائج للعربية، فجربه بنفسك قبل الاعتماد عليه في نصوص عربية.
### هل يعمل مع SGLang أو vLLM؟
نعم. يشرح دليل AWS الطريقتين على SageMaker HyperPod Inference، وصيغة FP8 نفسها أعدت بأداة llm-compressor من فريق vLLM.
### هل هو أرخص من واجهة مغلقة؟
فقط مع استخدام كثيف ومستمر. خادم ml.p5.48xlarge يعمل باستمرار يكلف نحو 46,206 دولارا شهريا، وهو ما يعادل قرابة 4.6 مليار رمز مخرجات بسعر gpt-6.1-sol المعلن.
## المراجع
- [إعلان Beam من Reflection](https://reflection.ai/blog/introducing-beam)
- [بطاقة نموذج Beam 1.0 (BF16) على Hugging Face](https://huggingface.co/reflection/Beam-1.0-501B-A23B)
- [نسخة FP8 على Hugging Face](https://huggingface.co/reflection/Beam-1.0-501B-A23B-FP8)
- [نسخة NVFP4 على Hugging Face](https://huggingface.co/reflection/Beam-1.0-501B-A23B-NVFP4)
- [تشغيل Reflection Beam على AWS، مدونة AWS للتعلم الآلي](https://aws.amazon.com/blogs/machine-learning/introducing-reflection-beam-an-open-weight-model-for-agentic-coding-on-aws/)
- [Beam على SageMaker JumpStart وAWS Trainium، صفحة What's New](https://aws.amazon.com/about-aws/whats-new/2026/01/reflection-beam-on-sagemaker-jumpstart-and-aws-trainium/)
- [أسعار Amazon SageMaker AI](https://aws.amazon.com/sagemaker/ai/pricing/)
- [أسعار Amazon EC2 حسب الطلب](https://aws.amazon.com/ec2/pricing/on-demand/)
- [خوادم Amazon EC2 P5](https://aws.amazon.com/ec2/instance-types/p5/)
- [خوادم Amazon EC2 P6](https://aws.amazon.com/ec2/instance-types/p6/)
- [بطاقة Kimi K3 على Hugging Face](https://huggingface.co/moonshotai/Kimi-K3)
- [بطاقة DeepSeek V4.1 Flash على Hugging Face](https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash)
- [بطاقة GLM 5.3 على Hugging Face](https://huggingface.co/zai-org/GLM-5.3)
- [بطاقة Qwen3-Coder-Next على Hugging Face](https://huggingface.co/Qwen/Qwen3-Coder-Next)
- [بطاقة Devstral 2 123B على Hugging Face](https://huggingface.co/mistralai/Devstral-2-123B-Instruct-2512)
- [أسعار OpenAI API](https://platform.openai.com/docs/pricing)